プログラマでありたい

おっさんになっても、プログラマでありつづけたい

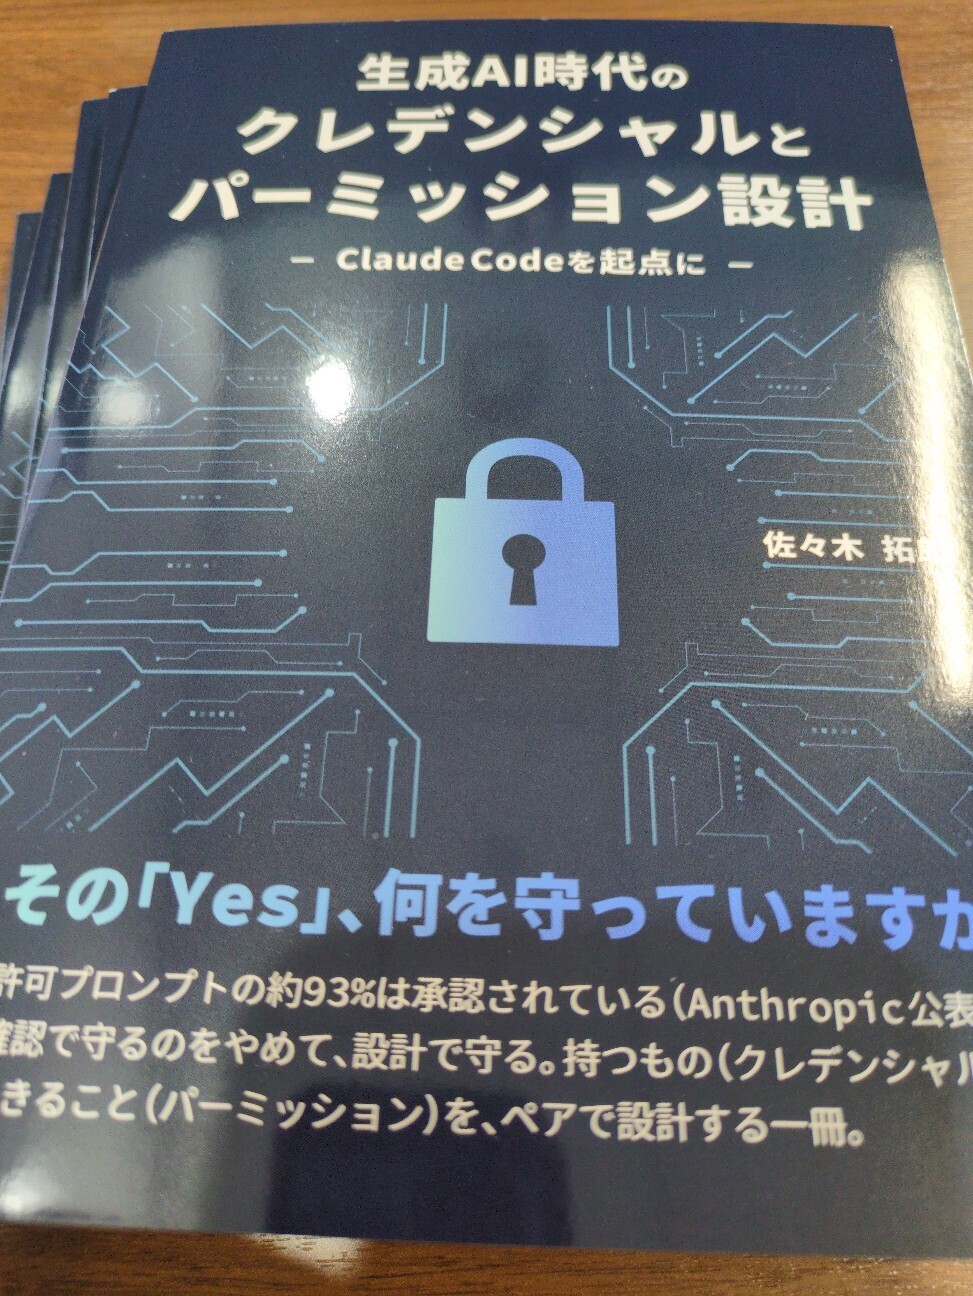
『生成AI時代のクレデンシャルとパーミッション設計』を執筆しました。本日発売です

 本日 9 月 10 日、BOOTH で新刊『生成AI時代のクレデンシャルとパーミッション設計 - Claude Code を起点に』を発売しました。BOOTH の商品ページから購入できます。また、DeveloperZineで Developers Summit 2026 KANSAI のベストスピーカーが発表され、同じ主題で話した 8 月の講演(A-6)が 3 位に入りました。大阪で 30 分話したときのスライドはSpeakerDeckで公開されています。聞いてくださった方、投票してくださった方、ありがとうございました。

 5 月に書きますと宣言した本が、これです。ようやく出せました。
■ きっかけは、席を外した事での気付き

 この課題感のきっかけは、自著を音声化する小さな個人プロジェクトの経験です。AWS の Polly に Claude Code から API を叩かせて朗読音声を作る作業で、CLI には AWS SSO で取得した一時認証情報を設定していました。有効期限は 60 分です。長めの作業なので、起動して後は任せて席を外していました。

 戻ってみると作業は終わっておらず、途中で止まっていました。許可プロンプトの待ちによる中断ではなく、一時クレデンシャルの期限切れでした。これ自体は、特に大きな問題ではなく、手元で SSO の再認証すれば済む問題ではありました。

 一方で再開しようとして IAM ロールを見直したところ、過去の作業で付けた広い権限が、そのまま残っていました。作業の中断より、こちらのほうが気になりました。

 広めの権限と自律実行は、掛け算で大きな事故になる可能性があります。片方だけなら影響は限られますが、両方が揃うと、想定していない操作が想定していない範囲まで届いてしまう可能性があるからです。だから「何を持たせるか(クレデンシャル)」と「何をさせるか(パーミッション)」はペアで設計する必要があります。片方だけ整えても、もう片方から想定外の操作が通ってしまいます。これが本書の主題です。

■ 確認で守るのをやめて、設計で守る

 では、都度の確認はこの構造を止めることができるのでしょうか。みなさん、Claude Code の許可プロンプトに、ほぼ全部 Yes を押していませんか?私もそうでした。Anthropic が 2026 年 5 月に公表したところによると、許可プロンプトの約 93% は承認されているとのことで、私だけではなさそうです。その Yes は、何を守れるのでしょうか。

 本書の立場は次のスタンスです。セキュリティは事前設計で確保し、人間の都度判断をセキュリティ制御として当てにしない。セキュリティと自律性はトレードオフだ、とよく言われます。ただ、都度確認が形だけになっているなら、実はどちらも実現できていません。これは仕組みで両立させるしかない、というのが私の考えです。つまり、自分もAIも信用はしないということですw

 auto mode が既定になった今、やることは「許可の範囲を狭めて都度確認させる」ではなく、許可を広げたうえで、やらせないことの境界線を deny ルールで引くことです。これには順序があって、まずコンテナや Sandbox で実行環境を固め、次にパーミッション設計で「許してよい範囲」を確定し、その範囲は任せます。人がその都度判断しなくて済む状態を、設定で先に作っておくわけです。この順序を、設定テンプレート付きで解説するのが本書です。

 理想を言えば、最初から完成系で組めればよいです。でも現実には「もう使っていて、設定は初期値のまま」から始まる方が多いのではないでしょうか。本書もそこからのどう改善していくのか解説しています。

■ 何を持たせ、何をさせるか。本書の中身

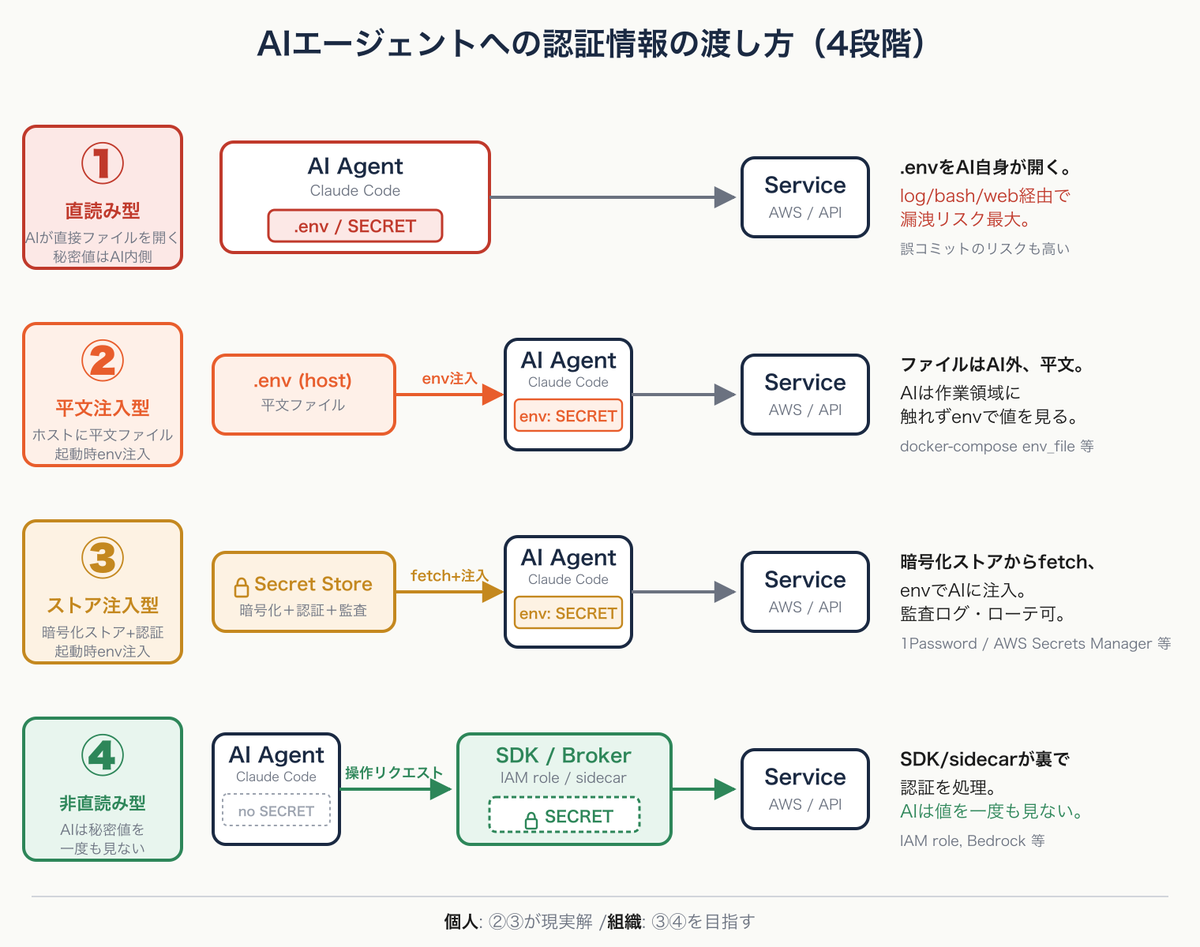
 AI に鍵(クレデンシャル)をどう渡すかは、「どこに置くか」の話ではなく「AI に読ませるかどうか」の話だと本書では整理しています。第5章では、AI が秘密値にどう触れるかを 4 段階に分けて解説しています。

第 1 段階 直読み型。AI が .env や ~/.aws/credentials を自分で開く
第 2 段階 平文外部注入型。平文の秘密値を AI の外に置き、起動時に環境変数で渡す
第 3 段階 ストア経由注入型。暗号化されたシークレットストアから取り出して環境変数に注入する
第 4 段階 非直読み型ブローカー。AI は秘密値を一度も見ず、SDK や IAM ロールが裏で認証を処理する

 段階が進むほど、AI が秘密値に触れる機会は減ります。目指すのは第 4 段階です。ただ、理想だけ書いても、いま第 1 段階で動かしている方の次の一歩にはなりません。そこで規模別の現実解も表にして添えました。個人開発者ならまず第 1 段階を避け、第 3 段階、つまり op run や Secrets Manager からの注入をコンテナと組み合わせるところまでを目指します。組織なら第 3 段階で監査と認証の要件を満たしておき、自動化の要件が出たときに第 4 段階、Bedrock と IAM ロールの組み合わせなどへ移る、という筋です。自分の現在地と次の一歩を選ぶための表として使ってください。

 目次は次のとおりです。全 8 章と付録 4 本で構成しています。

第1章 Claude Code のクレデンシャル × パーミッション地図
第2章 パーミッション設計 — settings.json・hooks・CLAUDE.md
第3章 隔離戦略 — Sandbox・コンテナ・機微ファイル
第4章 API 経路と AWS 連携
第5章 シークレット集中管理 — AI に渡す/渡さない設計
第6章 外部リソース連携 — MCP と外部サイト参照
第7章 チームで扱う — テンプレ化と共有
第8章 セキュリティと監査

付録A 個人/チーム/業務向け settings.json テンプレ集
付録B .mcp.json テンプレ集 + ガイドライン文書テンプレ
付録C Claude Code × AWS Bedrock 設定レシピ
付録D 参考: 関係する業界フレーム

 想定しているのは、Claude Code を使い始めた個人開発者と、組織導入を検討するエンジニアです。今日初めて触る方は、第1章のクイックスタート「最初の 30 分でやる 4 つの設定」と付録A から読んでください。4 つとは、機微ファイルの読み出しを deny で禁止すること、Sandbox を有効にすること、許可モードを Manual にして使い始めること、trust dialog には .claude/ の中身を見てから答えることです。ここはコピペで進めて、背景は各章で読む構成にしています。

 付録には settings.json、.mcp.json、Bedrock の設定テンプレートを収め、貼って動かすところまでを本の範囲にしています。ただし、貼れば終わりではありません。どの設定を組織として固定し、どれを推奨に留め、どれを個人の裁量に残すかという切り分けは、テンプレートを貼っても決まらないからです。個人運用なら自分で決めれば済みますが、チームで共有する settings.json や .mcp.json は、誰がどこまで強制するかを決めて初めて、チームで使える設定になります。

■ 30 分では話せなかったところ

 デブサミ関西で同じ主題で 30 分でまとめています。が、順序と考え方の説明までが精一杯でした。講演を聞いてくださった方にも、本書でより具体的な解説をしています。

 MCP サーバに何を持たせ、.mcp.json をどう組むかは、MCP サーバをクレデンシャルブローカーとして使う構成まで含めて第6章で扱います。前述の切り分けと、ガイドライン文書に何を書いて何を強制しないかは、第7章と付録B です。Claude Code の操作と監査証跡の考え方についても、第8章に簡単にまとめています。どういうことを考えないといけないのかの整理の一助になるはずです

■ 仕様と入手方法

 内容は 2026 年 8 月時点の Claude Code の仕様に基づいています。動きの速い領域なので、変化はどんどん出てくるとは思います。ただ基本的な考え方を示しているので、それこそAIにこういうことをやりたいのだよと指示を出すと、その骨格に沿って最新の情報を調べながら構築してくれるはずです。実際、私もそうやって構築してきました。

 技術書典21(2026 年 11 月)でも頒布します。また、2019 年に出した初代を全面改訂する『AWSの薄い本 IAMのマニアックな話』改訂第2版も予定しています。AWS観点で生成AI時代のIAMをどうするかを書く予定です。Claude Code 側を本書、AWS 側を改訂第2版という分担です。本書の第4章、AWS 連携の章は短命クレデンシャルと監査の部分をより具体的に書こうと思っています。
takuros.booth.pm

AIがコードを書く時代に、開発者は何を学ぶべきなのか。AWS認定デベロッパーの対策本を書きました

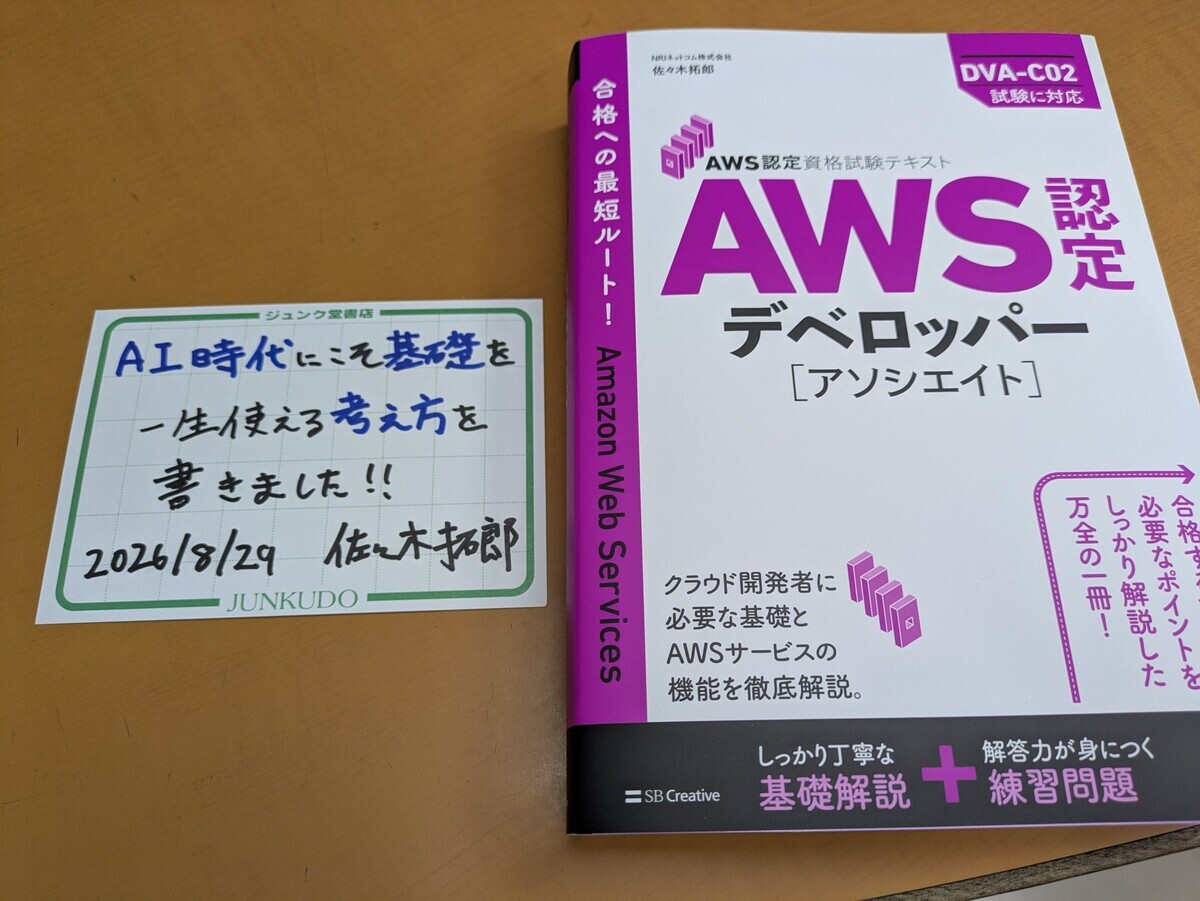
 AWS認定デベロッパーの対策本を書きました。発売日は8月28日なので、もう既に書店にも並び始めています。
 そしてこちらの写真は、ジュンク堂書店 池袋本店に書かせて頂いたポップです。


AI時代にこそ基礎を
一生使える考え方を
書きました!!

※下手くそな字で申し訳ありません

 たった3行ですが、この本の執筆を通じて考えていたことを凝縮しています。ここでいう基礎はAWSのサービス知識ではなく、開発者が持つべきAWS以外の一般的な知識と考え方です。
 AIが発展したことにより、解らないことがあればAIに聞けばすぐに答えを得られます。そのような状況下で、我々開発者には何が必要になるのでしょうか。私は、最後に残るのは、なぜそうしたのか、またそこに至る判断基準を説明可能であることと考えました。
 なので、本書ではただのAWSの機能の解説ではなく、開発者一般向けの知識と考え方を重点的に解説しています。試験に受かるだけでなく、更に実務にも役立つことを第一に考えた構成となっています。こういう部分こそAI時代に必要だという思いを込めて、しっかりと盛り込みました。結果かなり分厚い本になってしまったのですが、このまま出版させてくれたSBクリエイティブおよび担当編集者には感謝しかありません。ありがとうございます

本書の構成

章立てとページ数

 本書は9章構成で、本文は533ページに及びます。なお、目次等あわせると560ページです。試験対策本としては分厚いですよね。

章 範囲 ページ数
1 AWS認定資格 1〜24 24
2 AWS開発の基礎と前提 25〜60 36
3 AWSのベストプラクティスに沿った設計と運用 61〜86 26
4 AWSサービスによる開発Ⅰ(アプリケーション実装・Lambda) 87〜156 70
5 AWSサービスによる開発Ⅱ(データストア・連携) 157〜238 82
6 セキュリティ 239〜308 70
7 デプロイ 309〜374 66
8 トラブルシューティングと最適化 375〜438 64
9 問題の解き方と模擬試験 439〜533 95

AWSの解説に入る前に前提とする考え方の共有

 第2章と第3章の62ページは、前提と考え方に使っています。2-1「AWSアーキテクチャの基本概念」では、AWSサービスの個々の説明の前に、それぞれのサービスが前提とする考え方を説明しています。第3章ではWell-Architectedの紹介と、その中でデベロッパー試験を受験するにあたって重要な部分の解説をしています。

 例えば2-1では、疎結合と密結合、ステートフルとステートレス、同期と非同期、マイクロサービスとイベント駆動、回復性パターンなどを説明しています。この項目名に、AWS固有の用語が1つも入っていません。POPで「基礎」と圧縮したのは、この62ページのことです。

 試験の得点効率だけで見れば、この62ページは直接的な内容ではないかもしれません。飛ばして第4章から読み始める人もいるかもしれません。それでも先頭に置いたのは、AWS認定試験を受ける人にはこういったことこそ学んで欲しいと思っているからです。機械的な暗記で、例えば非同期処理を実装するにはSQSだと覚えれば試験は合格するかもしれません。でも、それで腑に落ちて実践で使えるのだろうかという疑問は以前からありました。なので、もう一歩踏み込んでの解説をしています。

試験対策以上の知識

 試験対策以上の知識を書いているところは随所にあります。これがどういうことなのか、いくつか紹介してみます。

サーキットブレーカー

 Closed・Open・Half-Openの状態遷移を説明したうえで、AWSにはビルトインのサーキットブレーカーサービスがないと書きました。実装にはpybreaker、tenacity、Resilience4j、opossumといった言語ごとのライブラリを使います。Step FunctionsのRetry・Catch・Waitで近い振る舞いは組めますが、複数実行をまたぐ遮断状態はDynamoDBなどの外部ストアに持たせます。この辺りはAWS側ではなく、どちらかというとアプリ側の実装に帰するものです。そういったところまで、少し越境しています。

API Gatewayと同期・非同期の考え方

 API Gatewayの29秒制限は、REST APIのRegionalまたはPrivateなら上限緩和を申請して延ばせます。ただし上限が消えるわけではないので、長時間処理は非同期に切り替えるという設計判断が必要です。緩和は緊急避難的な対応だと書き添えました。回避策だけを覚えるのではなく、実際にどう設計すべきか(この場合は非同期)を導出できるようにしています。

一生使える考え方とは?

 ここで、本書の「はじめに」に書いている内容を紹介します。

生成AIが当たり前にコードを書く時代に、人間のエンジニアには何が残るのでしょうか。筆者の答えは「判断」です。個別の知識どころか、いまや構成案そのものもAIが提案してくれます。それでも、その中からひとつを選び、結果に責任を取るのは人間です。理解できないものに、責任は取れません。

 さて、冒頭に書いている「一生使える考え方」とは、何なのでしょうか?
 例えばAWSサービスの名前や種類、推奨される構成は、この十数年で何度も入れ替わりました。ベストプラクティスは常に変わっていっているのです。それでも設計の考え方は、私がAWSを触り始めた頃から、大きくは変わっていません。

 例えば、失敗を前提としたアーキテクチャを考える場合は、こうなります。
 失敗を前提とすると、リトライが要ります。リトライするならば、その処理は冪等であるべきです。冪等というのは、同じ処理を2回実行しても、1回だけ実行したときと結果が変わらない性質のことです。またリトライが積み重なると、今度は呼び出し先に負荷が集中しすぎる可能性があります。そういった場合に備えて、サーキットブレーカーで、呼び出しそのものを一時的に止める設計が必要です。また、そもそも再実行で負荷が集中しないように、指数バックオフやジッターで呼び出しのタイミングが重ならないようにするのが良いでしょう。

 失敗前提、リトライ、冪等性、サーキットブレーカー、指数バックオフ・ジッター。これらを単に暗記するだけでは、このような順番で何が必要かは出てきません。前の決定により次に何が必要になるのか、関係性で理解する方が実際の設計・開発の場面では役に立ちます。AIからの回答を理解するには、こういった全体の流れが頭に入っている必要があります。

 私はこういったことを大事にしていきたいと考えています。

本書の想定する4種類の読者

 本書は、次の4種類のペルソナを設定して書いています。

  • 試験を受ける人。これは当たり前ですが、本書を読み切ると試験を受験するための体系的な知識を得られるように構成しています
  • 試験は受けないが、開発でAWSを触る人。第4章から第8章までが、サービスごとの実装と運用の話です
  • AIに実装させているが、出てきた設計を判断しきれない人。全般を通じて、判断するための考え方をちりばめています
  • 新人教育の教材を探している人。第2章と第3章は、AWSを使っていないチームにも持ち出せるはずです

 560ページは、かなりの分量です。当てはまるところだけを拾い読みしても、役に立つように意識して作りました。

13年前に書いた技術者の価値

 13年前に、技術を伝えても、技術者の価値はなくならないという話という記事を書きました。価値があるのはノウハウそのものではなく、背景にある理解と考え方、技術を生み出す力のほうだ、という内容です。当時の背景は、人と人での知識の伝達と価値の毀損(しないよ)という話でした。いまはそこにAIが加わりました。たとえAIという登場人物が増えたとしても、価値が背景の理解にあるという構造は変わっていないと、私は考えています。
 本書を執筆していて、改めてエンジニアの価値というのはそういうものなんだろうと実感しました。

まとめ

 AWS認定デベロッパーの書籍紹介をしようとしたら、ポエムのような内容になってしまいました。私も、もう25年以上、四半世紀、ITエンジニアをやっています。今までの経験の中でも、AIによる構造の変化は、かつてないほど影響が大きいとみています。そんな中で、変わるもの変わらないものを見極めて、今までの経験を少しでも伝えることができればなと思っています。

 感想は #AWS認定 あるいは書名をつけてポストして頂けるとありがたいです。疑問点については、できる限りフォローしていきたいと考えています。

AWS Summit Tokyo 2026 直前予習:NYCキーノートで見えたAWSの注力領域、Amazon Quickと5つの新発表

来週、AWS Summit Tokyo 2026 が開催されます。毎年 NYC と Tokyo は開催時期も近いので、先に公開された NYC キーノートを読んでおくと会場での理解がかなり変わります。

今年の NYC キーノートは VP of Agentic AI の Swami Sivasubramanian が担当しました。全体を通じたメッセージは「Compounding Momentum(複利的な加速)」です。正しく作られたエージェントは使えば使うほど賢くなり、信頼が積み上がるほど任せられる範囲が広がる、という考え方です。

筆者の関心は Amazon Quick 寄りなので、その周辺を詳しく、他の新発表はまとめてご紹介します。

今年の AWS が一番力を入れているもの:Amazon Quick

Amazon Quickは「自分がほしい成果を宣言すると、全システム・全データ・全コンテキストを横断して手順を組み立てる AI アシスタント」です。マイクロソフトの Copilot や Google Gemini for Workspace と競合する領域ですが、AWS らしく「エンタープライズのガバナンスをどう両立するか」に軸足を置いています。

なお自動字幕では Amazon Q と誤認識されていますが、キーノート本編では一貫して Amazon Quick と発音されています。

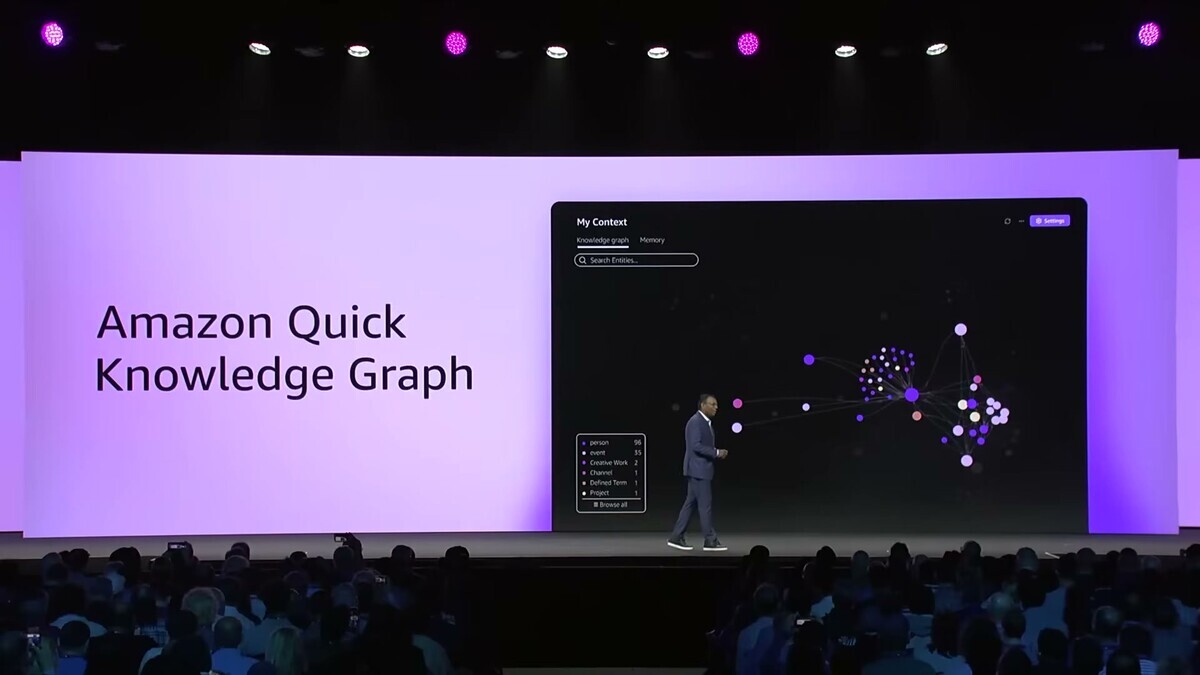
ナレッジグラフが核心

Quick の売りは「Knowledge Graph(ナレッジグラフ)」と呼ばれるアーキテクチャです。AWS は semantic knowledge store(意味的知識基盤)とも呼んでいます。単なるキーワード検索と違い、人・文書・コミュニケーション・データの関係性と意味を推論して答えを組み立てるとのことでした。


出典: AWS Summit New York City 2026 Keynote(00:11:10)

人・文書・コミュニケーション・データの関係を推論し、会話のたびに学習します。「使い始めた初日と100日後では別物になる」というのがキーノートでの説明でした。Amazon 社内ではすでに日次180万件以上のリクエストを処理しており、発表前からプロダクション運用していた数字です。

デモ:休暇明けの Slack を60秒で片付ける

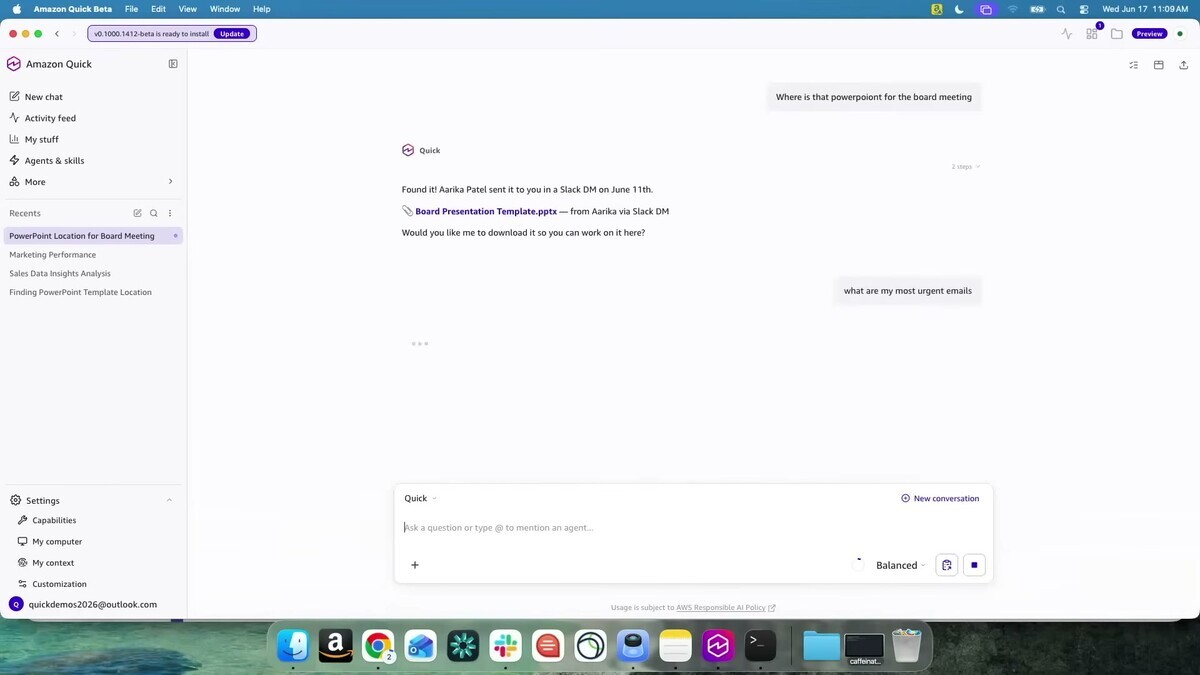
デモを担当した Brian Roer の設定が現実的でした。「休暇から戻ったら Slack もメールも溜まっている。役員会議用の PowerPoint がどこかの Slack スレッドに埋まっているが、誰が送ったかも覚えていない」という状況からスタートします。

Quick に「ボード用の PowerPoint ってどこにある?」と自然言語で投げると、送信者を指定しなくても Slack スレッドを探し出して直接リンクを返します。


出典: AWS Summit New York City 2026 Keynote(00:13:44)

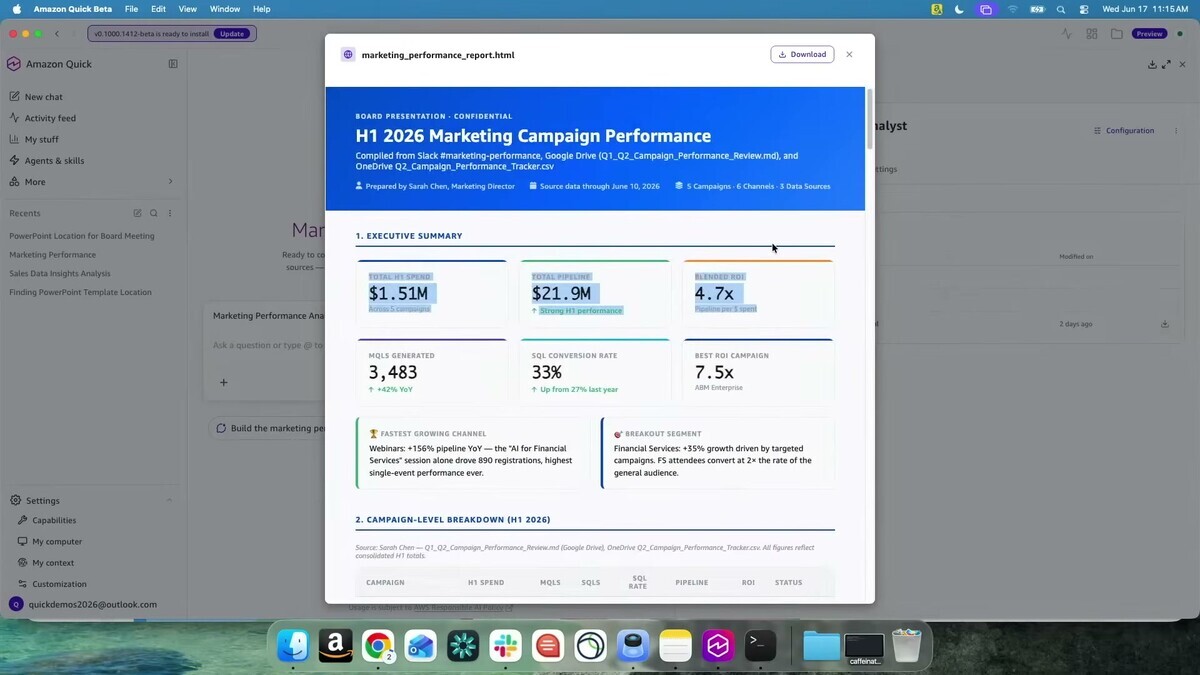
続いて Snowflake や Databricks に入っているデータに自然言語で問い合わせると、SQL を自動生成してダッシュボードを作ります。ここでは既存の Amazon QuickSight の可視化機能を活用しているとも説明していました。

最後に「これを毎週自動でやっておいてほしい」という流れで、エージェントとして登録する部分を見せていました。


出典: AWS Summit New York City 2026 Keynote(00:18:30)

24時間365日でレポートを最新状態に保ち続けるエージェントです。「コードを書けない人こそ Quick でエージェントを作ってほしい」という言葉が印象的でした。

Walled Garden vs Wild Garden:AWS の答え

今年のキーノートで一番示唆に富んでいた部分です。


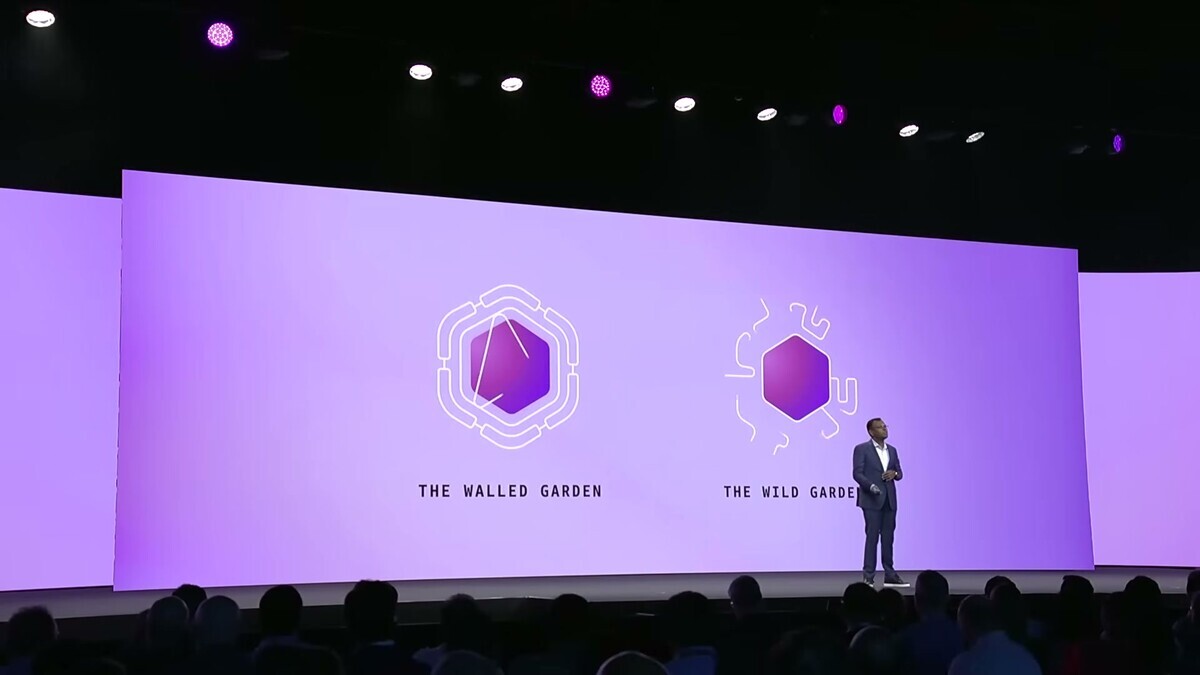
出典: AWS Summit New York City 2026 Keynote(00:20:00)

Swami はエンタープライズが今直面している二択を「Walled Garden(壁の中の庭)」と「Wild Garden(野生の庭)」で表現しました。

  • Walled Garden:Microsoft 365 など特定スイートに閉じている。セキュリティは担保されるが、データはサイロのまま
  • Wild Garden:オープンなツールを横断できる。ただしガバナンスがなく、データがどこへ行くかわからない

Quick はどちらでもなく、「横断しながら、アクション単位でガバナンスを持つ」と言っています。誰が、どのデータに、どこへアクセスし、ポリシーに適合しているかをアクションごとに記録・制御する設計です。IAM と VPC で慣れている AWS エンジニアには馴染みやすいアーキテクチャだと思います。

この辺り、各社の考え方の違いと勢力圏争いが垣間見えて面白いですね

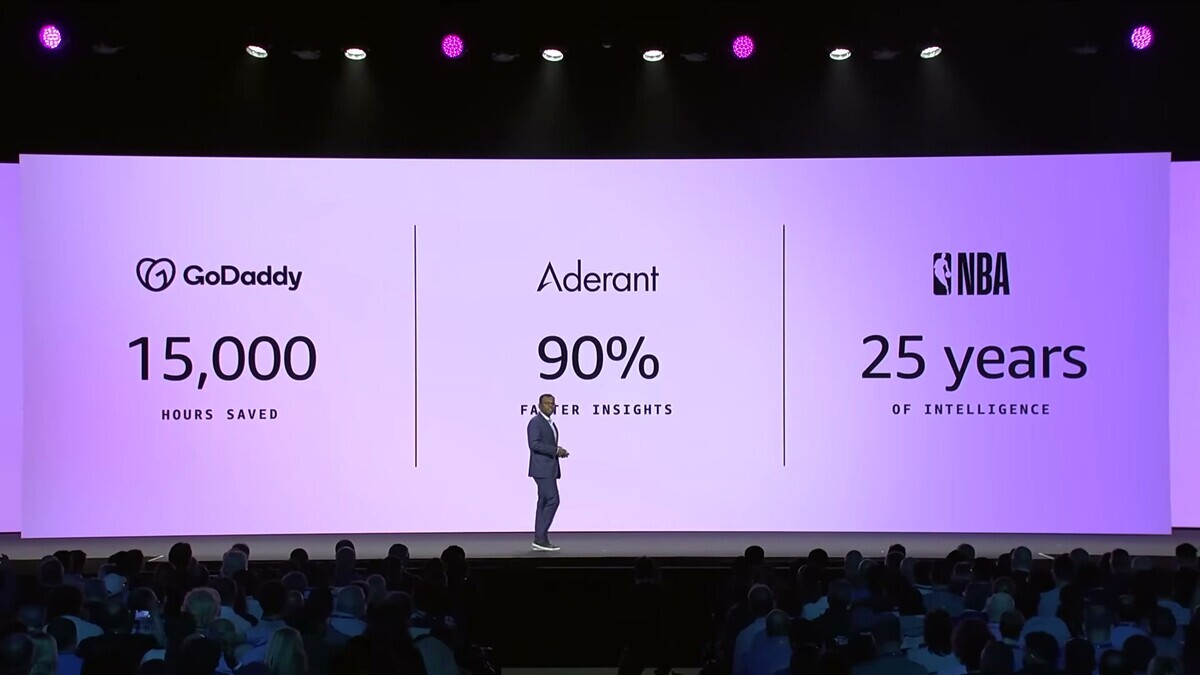
導入事例の数字


出典: AWS Summit New York City 2026 Keynote(00:21:15)

  • GoDaddy:年間15,000時間の手作業を削減
  • Aderant(法律向けソフトウェア):インサイト導出90%高速化、ドキュメント精度75%改善
  • NBA:25年分のドラフトデータを構造化してリーダーボード・選手比較・文脈ベンチマークに

いずれも「実験」ではなく本番稼働中の数字として紹介されていました。

そのほかの主要発表

AWS Continuum for Code Vulnerabilities(preview)

セキュリティ脆弱性対応をエージェントで自動化するサービスです。コードの脆弱性対応を「発見 → 優先度付け → 検証 → 修正」の4段階で処理します。

検証フェーズでサンドボックス環境に再現コードを生成して偽陽性を排除する点が特徴的です。「あなたの最も優秀なエンジニアと同じ視点で、ただし個別ではなくアーキテクチャ全体を見て判断する」という説明でした。

運用は2段階で、まず「alone mode(ヒューマン・イン・ザ・ループ)」で信頼を積み上げ、実績ができたら「enforce mode(自動修復)」に昇格できます。設計パートナーは MongoDB、Rivian、Robinhood、Capital One です。

あと全然関係ないのですが、Continuumと聞くと自分が初めて導入した継続的インテグレーションツールApache Continuum を思い出します。Maven連携でいろいろできたのですが、Maven職人にならないと使いこなせなかった。そして、Hudson/Jenkinsに駆逐されていきました。ここで同じ名前を目にするとは

Kiro + AWS DevOps Agent Release Management(preview)

Kiro はコード生成エージェントですが、「コードを書く前に仕様を固める」設計が特徴です。プロンプトを投げると要件・設計ドキュメント・タスク・検証テストを先に生成してから実装に入ります。Southwest Airlines が2,700人(エンジニアの約3分の2)に展開して近代化を3年前倒しした事例が紹介されました。

今回の新発表は iOS ネイティブアプリです。電車の中でタスクを起動してラップトップで続きから作業できる設計で、「思いついたときに動かせる」ことを強調していました。


出典: AWS Summit New York City 2026 Keynote(00:41:25)

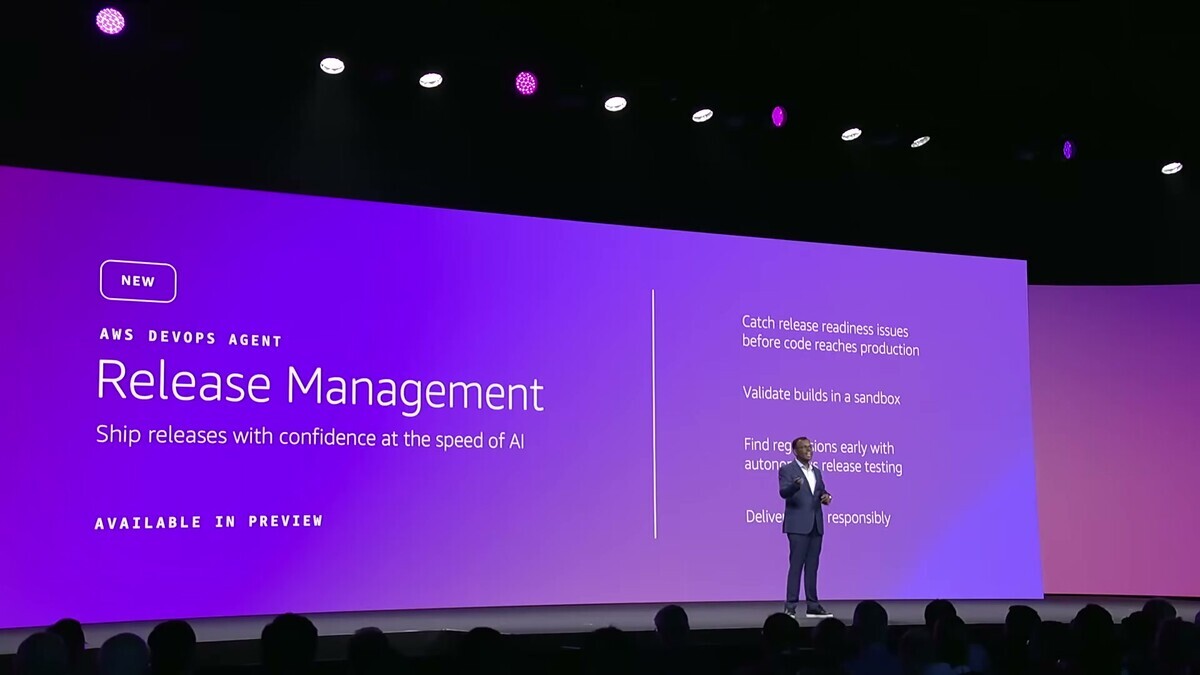
AWS DevOps Agent に追加された「Release Management」は、コード生成直後に本番リスク評価をかけるエージェントです。非自明な破壊的変更(他サービスへの影響など)を検出し、サンドボックスで探索的テストを実行します。コーディングエージェントとリリースエージェントが1つのフローでつながる設計です。

加えて AWS Transform に「continuous modernization」機能も追加されました(preview)。依存関係やフレームワークの陳腐化を継続的に検知・修正し続けるエージェントで、CodePipeline・Jenkins・GitHub Actions・GitLab と連携します。

Amazon Bedrock AgentCore GA

エージェントを本番運用するための基盤が一般提供(GA)になりました。


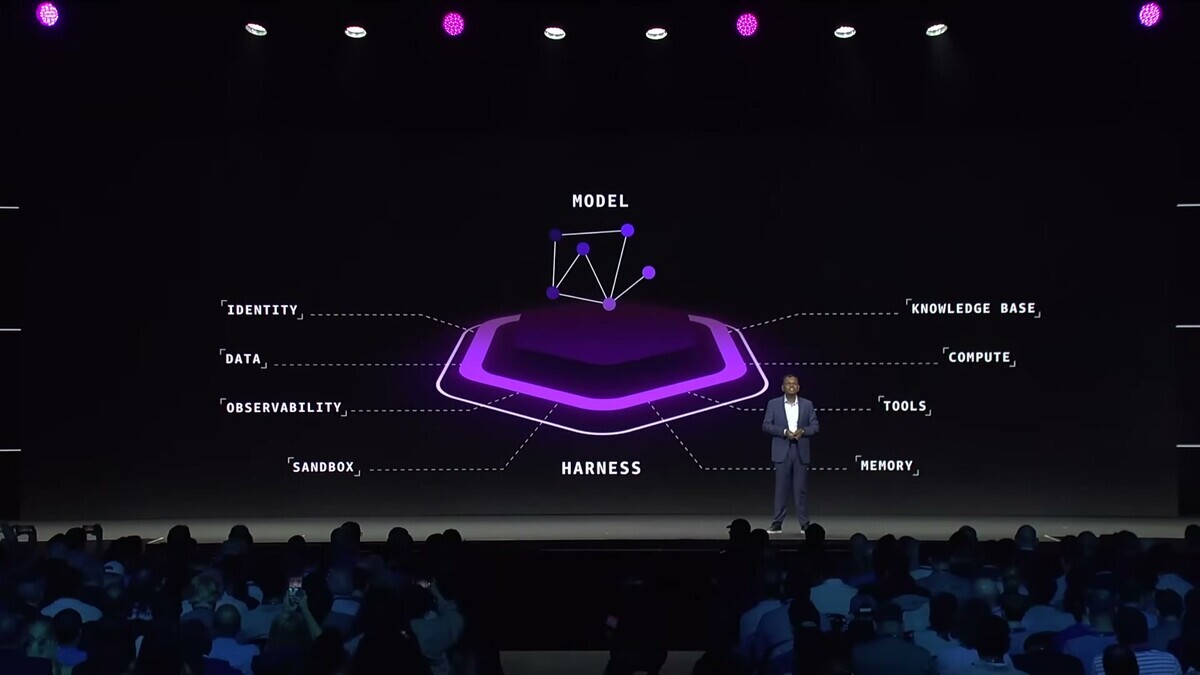
出典: AWS Summit New York City 2026 Keynote(01:00:00)

「モデルが脳、ハーネスが身体」という説明がわかりやすかったです。AgentCore はハーネス部分(状態保持・エラーリカバリ・コンテキスト管理・セッション分離・認証・オブザーバビリティ)を提供し、モデルとハーネスを分離することでモデルを差し替えてもハーネスを作り直さなくて済む設計です。

任意のフレームワーク・モデルで使え、細かい制御が必要になったら Strands ベースのコードにエクスポートして自前実装に切り替えられます。Strands は 2025年5月のオープンソース化以来、累計5,000万ダウンロードを突破しています。

AWS Context(新サービス、Coming Soon)


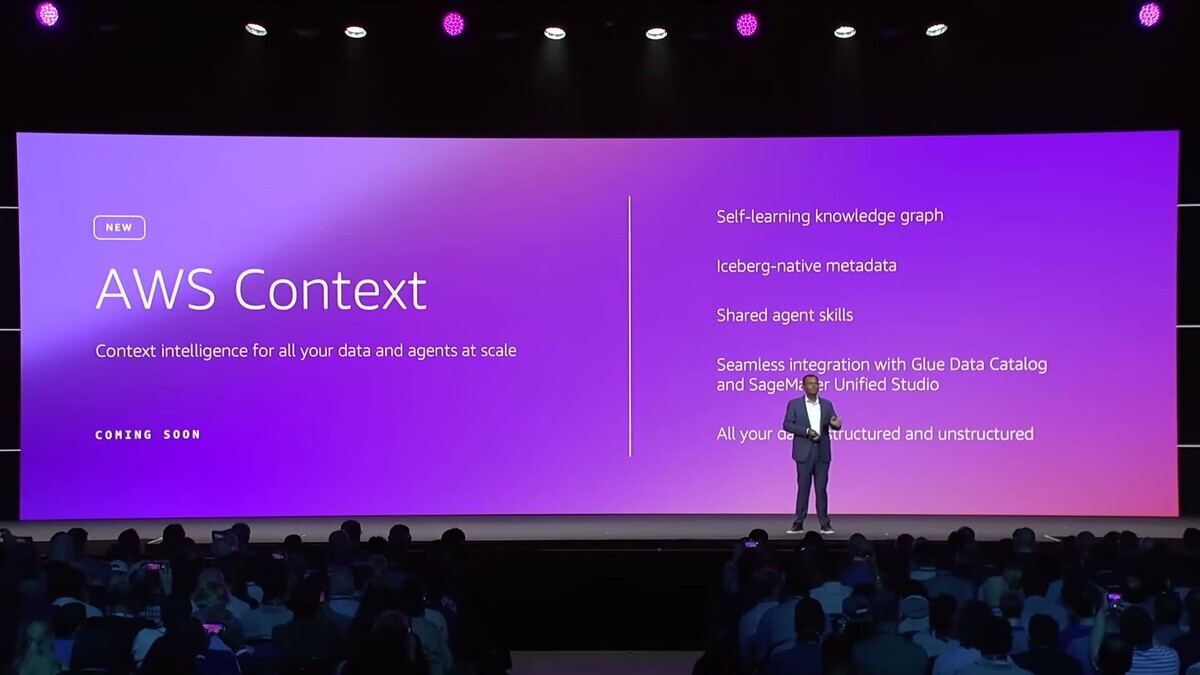
出典: AWS Summit New York City 2026 Keynote(01:12:00)

S3・SharePoint・Confluence・Google Drive などの全データから知識グラフを自動構築し、自己改善し続ける新サービスです。Iceberg ネイティブのメタデータ管理で、Glue Data Catalog と SageMaker Unified Studio と連携します。

エージェントから MCP ツールや agentic search API でアクセスできます。Amazon Quick の "sense store" と同じアーキテクチャを、自社のエージェント群に持ち込めるイメージです。

AWS Summit Tokyo 2026 で押さえるべきポイント

今年の流れを一言でまとめると「エージェントを実験から本番へ」です。

Amazon Quick の大規模導入はすでにAmazon社内で本番稼働の実績があり、それを支える AgentCore も今回 GA(一般提供)になりました。Summit Tokyo のセッションでは日本企業の導入事例や日本語対応状況について話が出るはずなので期待です。

Continuum・Kiro Release Management・Transform continuous modernization はいずれも preview 段階で、日本での展開時期はどうなるか気になりますね。また、Amazon Quick の Knowledge Graph と AWS Context はどちらも知識グラフを自動構築しますが、役割の違いが現時点ではまだ整理しきれていないです。まだSummit NYCの個別セッションの動画は公開されていないので、その辺りの公開待つか、Summit Tokyoで聞けることを期待しています

Chrome DevTools MCP が凄い。人類が「プログラムにやってほしかったこと」が簡単にできる時代がきた!!

 Chrome DevTools MCP に最近触れていて、衝撃を受けています。
Chrome DevTools MCP は、Claude Code などの MCP クライアントから Chrome DevTools Protocol(CDP) を通してブラウザを操作する仕組みです。ざっくり言えば、「AI に、普段使っている Chrome をそのまま操作させるためのインタフェース」です。従来の Selenium や Puppeteer のように大量の操作コードを書くのではなく、「このボタンを押して」「CSV をダウンロードして」と自然言語で指示できるのが特徴です。

 過去にクローラー本を書いてきた人間として言うと、人類が「プログラムにやってほしかったこと」がかなり自然に実現できる時代になった、という感覚があります。HTML 要素を 1 つずつ調べてセレクタを書く、という作業を延々やらなくて済みます。10 年前、Ruby でクローラー/スクレイピングをやっていて、多少長く見てきました。著者名義で最初に出した商業誌も、AWS の本ではありません。実はクローラー本で、『Rubyによるクローラー開発技法』(2014 年)を書きました。当時は対象サイトの DOM 構造を眺めて CSS セレクタを当て、ログインの POST を再現し、Cookie を保持し、レンダリング時間を sleep で待つ、という地味な作業の繰り返しでした。

 その後 Selenium、Puppeteer、Playwright と進化してきましたが、本質は変わっていません。「ログイン状態の Chrome を、人間に代わって動かしたい」という要件には、毎回それなりの工数がかかっていました。

 それが Chrome DevTools MCP で根本から変わりました。具体例と運用の知見を、その間にあった「もう一段階」も含めて整理しておきたいと思います。

プログラミングと MCP の間にあった SaaS スクレイピング

 「コードを書かずに、ブラウザで対象ページを指定すればスクレイピングできる」という SaaS が 2010 年代に複数登場しました。代表例が KimonoLabs(2014 年創業、Y Combinator 出身)です。Chrome 拡張で対象サイトの欲しい要素をクリックすると、API として叩けるエンドポイントを発行してくれる、という建付けでした。当時はかなり盛り上がって、自分も試した記憶があります。

 KimonoLabs は 2016 年に Palantir に買収されてサービス終了しました。同時期に並走していた代表的なサービスを並べると、「決定版が出なかった」という構造が見えやすくなります。

  • import.io(2012 年〜): 現存。今は「AI-Native Web Data Extraction Platform」を名乗る企業向け路線
  • ParseHub: 現存。Visual point-and-click 系、月 189〜599 ドルのサブスク
  • Apify(2015 年〜): 現存、Prague 拠点、開発者向けマーケットプレイス路線
  • Scrapinghub(2010 年〜): 2021 年に Zyte に改名、エンタープライズ寄りに軸足を移した

 他にも Octoparse、Mozenda、80legs などが並走していましたが、上の 4 社で大筋の流れは見えます。存続している会社は多いです。ですが、誰もが知るスクレイピングサービスの決定版は出ていません。大きく 3 パターンに収束しました。一つはエンタープライズ向け契約に逃げる路線(Zyte、import.io)。一つは Visual builder のニッチで小さく続ける路線(ParseHub)。もう一つは開発者向け基盤に振り切る路線(Apify)です。

 決定版が出なかった理由は構造的です。スクレイピング SaaS は対象サイト側から見ると、利用規約違反になりうる領域です(robots.txt の解釈、レート制限、認証越え)。サービス提供者がスケールするほど対象サイトとの摩擦が増えます。法務・倫理面の不確実性が事業継続のリスクになります。結果として「コードレスで誰でもスクレイピング」というマス向けの展開は実現しませんでした。

 ここに Chrome DevTools MCP が出てきた、という時系列で見ると意味が違って見えてきます。

Chrome DevTools MCP がやってくれること

 公式は chrome-devtools-mcp です。Claude Code などの MCP クライアントから「Chrome の DevTools プロトコル」越しにブラウザを操作するサーバで、Puppeteer をバックエンドにしています。

 何が革命的かというと、次のような点です。

  • DOM スナップショット(aria/role 付き)が取れる。Claude が「メニューの『売上CSV』をクリック」を文字情報として理解できる
  • セレクタを書かなくていい。「『発行する』ボタンを押して」で通る
  • ログイン状態は Chrome プロファイルに委ねる。MCP 側はパスワード管理ロジックを一切持たない
  • ダウンロードリンクを押した後、保存先を固定してファイル出現を待たせられる
  • Headless / Headed を切り替えられる(CAPTCHA や追加確認が出たときに人間が確認しやすいので headed が扱いやすい)

 書き方が変わります。Selenium ならコードだったところが、Claude へのプロンプト(スラッシュコマンド)になります。それでだいたい動きます。

 そして KimonoLabs のような SaaS スクレイピングと違って、Chrome MCP はユーザの手元の Chrome を動かすだけです。中央集権型サービスが対象サイトとの摩擦を抱える構造ではありません。各ユーザが自分のブラウザで自分のアカウントの管理画面を操作するだけなので、サービス提供者がスケールしてバンされる、という事態は起きにくいです。第二幕の SaaS スクレイピングが解決できなかった事業継続性の問題を、構造的に回避しています。

実用例: BOOTH と Kindle ダイレクトパブリッシングの売上を自動取得する

 私のリポジトリには `/fetch-booth` と `/fetch-kdp` という Claude Code のスラッシュコマンドを置いています。やっていることは次のような流れです。

 `/fetch-booth` の場合:

  1. `https://manage.booth.pm/orders` に遷移
  2. 注文一覧のスナップショットを取る
  3. 既存 CSV の mtime と最新注文日時を比較(鮮度チェック)
  4. 必要なら売上 CSV 発行画面に遷移して、期間指定 → 「発行する」をクリック → ダウンロード待ち
  5. ダウンロードフォルダに落ちた CSV を `analytics/raw/booth/` に配置

 `/fetch-kdp` の場合:

  1. KDP のログイン状態を確認(2 段階認証を要求されたら中断してユーザに依頼)
  2. レポート画面で Orders と KENP Read を順に発行 → ダウンロード
  3. xlsx をパースして JSONL(共通スキーマ)に変換

 これを Selenium で書いていたら、要素セレクタを当てて、ログインの維持を確認して、ダウンロードイベントの待機を自前で書いて、というコードが数百行はかかります。さらに UI 改修があるたびに直す必要があります。

 Chrome MCP では、コマンド定義が Markdown で 70〜80 行程度です( `/fetch-booth` が 79 行、`/fetch-kdp` が 71 行)。Claude が毎回スナップショットを取って判断するので、UI が少し変わっても通ります。根本的な構造変更があれば指示文を直しますが、その粒度は Selenium のセレクタ修正よりはるかに楽です。再実装の保守コストが激減します。

 ポイントは、CSV 発行枠に「BOOTH は 30/日」のような制限があるところです。鮮度チェックを入れて無駄打ちしないという判断を、Claude にスナップショットを読ませて任せられます。これは Selenium 自前実装でも書けますが、Claude の判断委譲のほうが運用が楽です。

認証は Chrome 側に委ねる。ただしセッションは強い権限であることを留意する

 セキュリティ観点で気になるのは「Claude にパスワードや 2FA コードを渡したくない」という点です。Chrome MCP では、少なくとも Claude にパスワードや 2FA コードを入力させずに運用できます。ただし、ログイン済み Cookie / セッションを使って操作するため、認証リスクが消えるわけではありません。

 ログインは事前に手動でプロファイルを作るときに 1 回だけ実施します。以降は Chrome プロファイルに保存された Cookie やセッションがそのまま使われます。Claude にパスワードを入力させる必要はありません。

 ただし注意点として、MCP クライアント側はブラウザの内容を inspect/modify できる立場にあります。公式 README でも、ログイン済み画面の DOM や Cookie・localStorage に保存されたトークン類は MCP 経由で読み取りうることが明記されています。だからこそ「専用プロファイルを切る」「読み取り中心の運用に限定する」「他サービスのログインを混ぜない」という運用ルールが効いてきます。パスワードを直接渡さない、というのはあくまで一段目の防御です。

 2FA や OTP、CAPTCHA が要求されたら、Claude は中断してユーザに依頼する設計にしておきます。`/fetch-booth` と `/fetch-kdp` はこの方針です。課金確定アクション(決済実行や広告出稿など)はやらせません。読み取り中心の運用で十分元が取れます。

 「パスワードを AI に直接渡さない」運用にし、専用プロファイルでアクセス範囲を絞れば、リスクは局所化できます。ただし、Cookie / セッションは MCP クライアント側から読み取りうる状態なので、サイト側が再認証を要求しない操作については、実質的にパスワードを渡しているのに近い権限委譲になります。リスクを理解した上で、何を許すかは利用者側でしっかり考える必要があります。

ちょっとした詰まりどころ: MCP 専用 Chrome プロファイルを用意する

 完全にスムーズというわけではありません。運用上のコツとしては、MCP 専用の Chrome プロファイルを用意するのがおすすめです。普段使いの Chrome と同じプロファイルで MCP を動かそうとすると、Cookie の暗号化や同時起動の扱いで混乱しやすく、ログインが消えたように見えるトラブルにつながります。専用プロファイルを切っておけば、ログイン状態の保持も判断もシンプルになります。

 具体的には、Chrome MCP の専用プロファイルは `--use-mock-keychain` フラグ付きで起動されます(Puppeteer の既定)。手で同じプロファイルから Chrome を立ち上げるときも、同じフラグを付けないと Cookie の暗号化キーが食い違って、ログインが消えたように見えてしまいます。
 なお、このフラグは利便性のためのものですが、OS のキーチェーン保護とは別の鍵管理になるため、ローカルマシン上の攻撃面は増える可能性があります。専用プロファイルに他サービスを混ぜない理由もここにあります。

"/Applications/Google Chrome.app/Contents/MacOS/Google Chrome" \
  --user-data-dir="$HOME/.chrome-mcp-profile" \
  --use-mock-keychain

 このフラグ付き起動でしかアクセスしない、というのが運用ルールです。詰まりどころというより、最初に決めてしまえば困らない範囲です。

これから試したいこと

 `/fetch-booth` と `/fetch-kdp` の次に、同じ仕組みで広げたい用途がいくつかあります。

  • OGP 監査(各 URL の OGP 画像と meta タグを一括チェック)
  • UTM の e2e テスト(BOOTH 商品ページから GA4 へ送られる内容の検証)
  • BOOTH 商品ページの棚卸し(価格・在庫・カバー画像の整合性)
  • ブログ記事の Web Vitals 計測(Lighthouse 連携)

 すべて「ログイン後画面とブラウザの状態を読みたい」用途で、Selenium で書いたら結構な工数ですが、Chrome MCP なら数十行のコマンド定義で済む見込みです。優先順位は ROI 順で、OGP 監査からと考えています。

まとめ

 Chrome DevTools MCP は凄いです。人類が「プログラムにやってほしかったこと」がかなり自然に実現できる時代になっている、というのが正直な感想です。

 10 年前にクローラー本を書いた身として、要素セレクタを当ててログインを維持して、というあの労力が「Claude にスナップショットを渡して指示」で済むようになったのは衝撃でした。途中の SaaS スクレイピングは事業構造の問題で決定版が出ませんでしたが、Chrome MCP はユーザの手元の Chrome を動かすだけなので、その問題を構造的に回避しています。

 上手く使えば、恩恵はかなり大きいと思います。読み取り中心の管理画面操作なら、まず試してみる価値があります。「パスワードを AI に直接渡さない」運用にし、専用プロファイルでアクセス範囲を絞れば、リスクは局所化できます。ただし、Cookie / セッションは MCP クライアント側から読み取りうる状態なので、サイト側が再認証を要求しない操作については、実質的にパスワードを渡しているのに近い権限委譲になります。

 最近は、Claudeを中心にAIの使い方についても、いろいろ考えています。よければ、気軽にTwitter(@dkfj)をフォローしてください。


『生成AI時代のクレデンシャルとパーミッション設計 — Claude Code を起点に』を書きます。個人開発者向けにコメント募集

 Claude Code に作業を任せて席を外し、戻ってきたらコマンド許諾待ちで止まっていた。そんな経験ありませんか。

 かといって全部 allow にしてしまえば、.env 読み出しや bash 任意実行のリスクが跳ね上がります。「席を外せる自律性」と「無制限許可の危険」のあいだに、どう線を引くか。この問いを 8 章で具体化する本『生成AI時代のクレデンシャルとパーミッション設計 — Claude Code を起点に』を、姉妹書と同時に 2026 年 11 月発売予定で執筆中です。

speakerdeck.com

 このエントリは上記 Speaker Deck の補足です。なぜこの本を書くのか、何を扱って何を扱わないのか、執筆中にコメントで聞きたいことを書きます。

なぜこの本を書くか

 きっかけは、自著を音声化する個人プロジェクトです。AWS Polly に Claude Code から API を叩かせて朗読音声を生成する、という小さなタスクです。

 CLI に AWS SSO から取得した一時認証情報を設定して、claude を起動しました。IAM ロールの有効期限は 60 分。作業の途中でこの期限が切れて、Polly が呼び出せなくなりました。再開するには手元に戻って SSO 経由の認証を踏み直す必要があります。

 長めの作業を任せて席を外したかったのに、認証情報の有効期限が壁になって止まってしまいます。「席を外せる自律性」を阻むのは、許諾プロンプトだけではない。クレデンシャルの寿命設計でも同じ構図で詰まる、と気付いたのがこのときでした。

 ここから本書の問いが固まりました。AI に何をどこまで任せるかは、「どんな権限(パーミッション)を渡すか」と「どんな認証情報(クレデンシャル)を渡すか」をペアで設計しないと、片方だけ整えても穴が残ります。

本書の問い 席を外せる自律性と無制限許可の危険のあいだ

 本書の問いは一文で書けます。

「席を外せる自律性」と「無制限許可の危険」のあいだで、どこに線を引くか。

 この問いには二つの懸念に紐づきます。

  • 許諾待ちで止まる事故。Claude Code を起動して席を外したのに、最初の Bash 実行で許諾プロンプトが出て、戻るまで何も進んでいない
  • 過剰許可で壊れる事故。bypassPermissions モードで放任した結果、.env が読まれた、想定外のファイルが消された、indirect prompt injection で外部 API が叩かれた

 Claude Code の settings.json / hooks / sandbox / コンテナ / シークレット集中管理 / MCP 設定の各層を、この問いに沿って具体化していくのが本書の構成です。

本書のスコープ ハーネスのうち security 軸に絞る

 本書はハーネスエンジニアリングの security / isolation / credential 軸に特化します。

 「ハーネスエンジニアリング」は Mitchell Hashimoto が 2026 年 2 月に提唱して急速に広がった用語で、Agent = Model + Harness、つまりモデル以外のすべてを harness と呼ぶ枠組みです。subagents / context compaction / feedback loop / orchestration など多面に及びますが、本書はそのうち security / isolation / credential 軸に絞ります。品質や効率を上げる harness 設計は対象外です。

 章立ては以下の通り。

  • 前書き 個人開発で Claude Code を使う前提と本書 stance
  • ch.1 クレデンシャル × パーミッション地図
  • ch.2 パーミッション設計(settings.json / hooks / CLAUDE.md / auto mode)
  • ch.3 隔離戦略(Sandbox / コンテナ / 機微ファイル / データ分類 4 levels)
  • ch.4 API 経路と AWS 連携(Anthropic API vs Bedrock)
  • ch.5 シークレット集中管理(中心章、AI に渡す / 渡さない設計)
  • ch.6 外部リソース連携(MCP と外部サイト参照)
  • ch.7 個人の環境を再利用可能にする(小規模共有まで)
  • ch.8 セキュリティと監査
  • 付録 settings.json テンプレ、.mcp.json テンプレ、Bedrock レシピ、業界フレーム照合

 主読者は、Claude Code を個人で日常的に使っている開発者です。ch.7 では作り込んだ環境を友人や副業先と共有するレベルまで扱いますが、組織導入の管理運用は本書の主軸ではありません。

中心章 ch.5 AI に渡す / 渡さない設計

 中心章は ch.5 です。本書独自のフレームを 2 つ置いています。

 一つ目は、AI が秘密に触れる程度の 3 段階モデル。

  • 第 1 段階 直読み型 AI が秘密値を直接読む(.env 直書き、~/.aws/credentials を素のまま使う、等)
  • 第 2 段階 限定直読み型 AI は読むが、影響範囲を mount 制御 / 短命化 / スコープ制限で削る
  • 第 3 段階 非直読み型 AI に秘密値を渡さず、操作だけを渡す(credential broker、Bedrock 経由、MCP-as-broker)

 「どこに置くか」ではなく「AI に読ませるかどうか」で credential 設計を整理する軸です。本書では 3 段階目を目指しつつ、現実解として 2 段階目を Sandbox / コンテナと組み合わせて受け止める設計を提示します。

 二つ目は、本書本命の broker を AWS Secrets Manager + aws-vault 一本に絞った話。1Password と HashiCorp Vault も最初は候補でした。ただ本書の問い(席を外せる自律性)に照らすと、個人ユースで自動リフレッシュ が回って構築負荷・コストも許容範囲に収まるのは (自分の中では)AWS Secrets Manager + aws-vault しかなかった、という選定です。

 1Password を試した経緯と、用途を絞って今も使っている話は、別エントリにまとめてあります。

blog.takuros.net

 このエントリの結論「個人プランの op signin は 30 分セッションで、無人バッチや短命トークンを伴う長時間タスクで壁に当たる」が、ch.5 で本命を AWS Secrets Manager に絞った理由の一つです。

姉妹書との関係

 『IAMのマニアックな話 AI時代の認証認可設計』と同時発売予定です。本書から IAM 一時クレデンシャルの基礎を大幅に削ぎ落とした代わりに、姉妹書との併読でカバーする構成にしました。Claude Code から AWS リソースを触る読者には、両書セットでの併読を推奨します。

コメント・フィードバック募集

 執筆中で、以下の点について意見を募集しています。コメントで教えてください。

  • 個人で Claude Code を使っていて、「席を外せず止まる」と「許可しすぎて怖い」、どちらで困ることが多いですか
  • secret 管理に何を使っていますか。.env 直書き / 1Password / aws-vault / Secrets Manager / その他
  • Bedrock 経由と Anthropic API key、どちらを選んでいますか。理由もあれば知りたいです
  • hooks / .mcp.json / settings.json など、Claude Code 環境をどう管理・共有しているか興味があります
  • sandbox / コンテナを、個人開発でどこまで使っていますか
  • 特に気になる章や、「ここをもっと深掘りしてほしい」というテーマがあれば教えてください

 はてブ、X、このエントリのコメント、どこでも構いません。

発売予定とリンク

 2026 年 11 月、姉妹書と同時発売予定です。技術書典または BOOTH での頒布を予定しています。反響大きければ、執筆ちょっと急いで、先に出すかもしれません

2026/09/10 書きました!!
booth.pm


booth.pm

booth.pm

AIエージェントに認証情報を安全に渡したい:1Passwordで試して、用途で使い分けに着地した話

 Claude Code のような AI エージェントに本格的に作業を任せようとすると、AWS の操作、外部 API への呼び出し、決済処理など、認証情報を渡す場面が増えてきます。

 ただし、AI に認証情報をそのまま読める状態で渡すのは危険です。bash 経由で外に出されたり、ログに残ったり、indirect prompt injection で使えと命令されたりすれば、秘密値はあっさり漏れます。

 そこで、AI には認証情報そのものを渡さず、必要な操作だけを実行させる仕組みを作れないかと考え始めました。設計の選択肢を整理すると、AI への認証情報の渡し方は大きく4段階に分かれます。

AIエージェントへの認証情報の渡し方(4段階モデル)

 ①は AI 自身が .env を読む状態で、漏洩リスクが最大。④は IAM role や Bedrock のように、AI が秘密値を一度も見ず SDK が裏で認証を処理する形です。多くの個人開発者にとっての現実解は ② と ③ で、組織で AI を本格導入するなら ③ か ④ を目指すことになります。

 この記事では、③ に該当する 1Password を AI エージェント用の認証情報受け渡しに使ってみた経緯を書きます。結論から書くと、用途を区切れば現在も使っているし、無人化したい段階になると壁にぶつかる、という話です。

1Password が候補として有望に見える理由

 最初に思いついたのが 1Password でした。理由は単純で、

  • 個人〜小規模で secret 集中管理といえば定番のツール
  • CLI (op) が成熟していて、op run -- <command> で env に注入してサブプロセスを起動できる。秘密値はプロセス環境にしか存在せず、shell 履歴にも残らない
  • Secret References (op://Vault/Item/field) で .env を「キー=参照」に置き換えられる。git に乗せても安全
  • 1Password アプリ連携を有効にしておけば、op run 実行時に必要に応じて Touch ID プロンプトが走り、UX が良い

 実際のワークフローはこの1行で済みます。

op run --no-masking --env-file=.env.tpl -- claude

 .env.tpl の中身は、値ではなく参照だけを並べます。

AWS_ACCESS_KEY_ID=op://Private/AWS/access_key_id
AWS_SECRET_ACCESS_KEY=op://Private/AWS/secret_access_key

※ここのキーは、一例です。実際に渡したかったのは、これではありません。

 op run の実行時に Secret References が解決され、env として claude に渡されます。

 4段階モデルでいうと ③ にあたる構成です。秘密値は 1Password vault という暗号化ストアに集約されていて、Touch ID 認証を経て AI エージェントの env に注入される。AI は env で値を見ますが、vault 自体には触れません。② の「平文の .env をホストに置く」よりも、認証・監査・ローテの面で大きく前進しています。

 ただし注意点として、env 注入された値は claude とその子プロセスにも環境変数として継承されます。さらに /proc/PID/environ 経由で読める、プロセスダンプや ps 出力・各種ログに混入する、といった漏洩経路もあります。AI 本体に秘匿値を渡す設計であることに変わりはないので、.env.tpl には必要最小限のキーだけを書くのが望ましいです。また、渡すキーの有効期限は短くすべきです。完全にAI が値を見ない状態にしたいなら ④ まで進める必要があります。

1Passwordで十分な利用シーン:短時間・有人タスク

 ここまで最初に思いついたと書きましたが、この後も用途に応じて 1Password と op を使い続けてる想定です。

 たとえば、週1回の Google Analytics データ取り込みのようなケースです。GA4 API 用の認証情報を 1Password に格納し、op run -- python ga_import.py の形で env 注入して、数分で完了します。

 なぜこの用途では問題にならないのか整理すると、

  • 起動を人が見届けている。op run 起動時の Touch ID プロンプトに答えられる
  • 扱う認証情報が静的な API key 中心。タスク途中で値が失効する心配がない
  • 頻度が週1回程度なので、毎回 Touch ID で認証するコストが許容範囲。むしろ「明示的に認証する儀式」がアクセス制御として機能している側面がある
  • 完全自律で AI に任せている訳ではなく、人が起動 → スクリプトが走る → 完了を確認、というサイクル

 つまり、broker の機能(認証で守られた vault からの env 注入)は使いつつ、無人での長時間自律は諦めている形です。1Password の制約と、タスクの性質が整合しているので現役で使えています。

 1Password を捨てた話でも、AI 用途では使えないと結論した話でもありません。用途が合えば手頃で便利、という話です。

無人バッチと短命トークンで当たる壁

 問題は、もう一段階自動化を進めようとしたときに出てきます。AI に席を外して数時間の作業を任せたい、あるいは GA 取り込みを cron や AWS Lambda で日次・週次の自動化に切り替えたい、といった場面です。

 ここで重要な前提として、op run による env 注入は起動時に1回だけ走ります。注入された値は claude プロセスのライフタイム中ずっと env として有効で、途中で 1Password に再アクセスする必要はありません。なので「30 分のセッション制約があるから長時間タスクで止まる」という話ではない、というのを最初に整理しておきます。

 壁が立つのは別の2つの場面です。

  • 無人バッチの場合: そもそも起動時刻に人がいません。cron で深夜に走らせても、Touch ID を押せる人がいないので op run の認証が通らない。タスク自体は数分で終わるのに、認証の入口で詰まる
  • 短命トークンを長時間タスクで使う場合: AWS STS のような短命クレデンシャルを op run で注入しても、有効なのは注入された時点のスナップショット。タスクが途中でトークン期限切れになると、子プロセスはリフレッシュできないので止まる

 永続的な API key(Anthropic API key、Stripe、GitHub PAT 等)だけを扱うなら、有人起動さえできれば op run は長時間タスクでも問題なく回ります。30 分制約が問題になるのは op を再実行するとき、たとえばプロセス内で動的に他の secret を取りに行く設計や、別プロセスが op を呼ぶ設計の場合です。すでに env 注入が済んだ claude プロセス自体には関係しません。

 私自身が壁を経験したのは2つ目で、別件で AWS の短命クレデンシャルを使った時に、実行中にトークンが期限切れになって作業が止まりました。op run は永続キーの broker としては筋が良いけれど、「短命トークンを実行中にリフレッシュする」用途には別の仕組みが必要です。

今後目指す方向性

 無人運用に進めるなら、選択肢は2つあります。

 無人起動の問題には、1Password の Service Account に切り替える方法があります。Service Account はトークンベース認証のため、Touch ID のような対話的な認証を介さずに起動でき、cron や CI で動かす用途には適しています。一方で、Service Account は人間ユーザーとは別の認証体系で動作し、通常の Personal vault や Shared vault とは切り離された運用になります。そのため、「人間用」と「機械用」のシークレットを分離し、専用の vault 構成を設計し直す必要があります。また、利用にはプランの制約や rate limit があり、実運用ではビジネス向けプランを前提とした設計になるケースが多く、導入時にはそれなりの設計コストおよび利用料がかかります。

 短命トークンのリフレッシュ問題は、env 注入を前提とした設計では本質的に解けません。op run は起動時に解決された値を env に渡すだけであり、aws-vault exec も基本的には同様に、その時点のクレデンシャルをプロセスに引き渡す形になります。いずれの場合も、プロセス内部にクレデンシャルの更新ロジックがなければ、実行中に期限切れが発生した時点で処理は停止します。

 本質的な解決は、プロセス自身がクレデンシャル更新の仕組みを内側に持つことです。AWS なら IAM role や instance profile を AWS SDK が直接参照し、credential provider chain が裏でリフレッシュを回す形にする。env で短命トークンを渡し回す設計から脱却できます。AI モデル本体を Bedrock 経由で呼べば Anthropic API key 自体も不要になり、4段階モデルでいう ④ に到達します。AWS をすでに業務でも個人でも使い倒している人なら、この経路への切り替えコストは比較的小さく済みます。

 私自身は AWS 寄りの判断をしがちな自覚があるので、後者を本命に置いています。最終的には、長期クレデンシャルをAIに渡すのではなく、IAM RoleやOIDCなどを使い、AIプロセス自体が一時クレデンシャルを取得する構成に寄せるのが望ましいと考えています。必要に応じて、Secrets Managerなどのストアを組み合わせて運用する形になります。

いま現在、見えている課題の整理

 ここまでの試行錯誤で、幾つかの課題と設計パターンが見えてきました。

 ひとつめ。broker を評価するときは人が起動を見届けるかと扱うクレデンシャルの寿命をセットで見ること。このツールは AI 用途で使える / 使えないという二分法は粗すぎます。有人起動 × 永続 API key、なら op run は長時間タスクでも快適に回ります。一方で「無人で起動する必要がある」「短命トークンを実行中にリフレッシュする必要がある」のいずれかが要件に入ってくると、op run 単体では不足で、別の経路を検討する必要があります。

 ふたつめ。業界定番だからという理由で AI エージェント用ツールを選ばないこと。1Password も aws-vault 或いはHashiCorp Vaultも、人間の シークレット管理では定番です。けれど「AI エージェントに無人で使わせる broker」という別問題に転用すると、評価軸が変わります。①自動リフレッシュの可否、②構築・運用コスト、③ユースケースとの整合、の3軸で見るのが筋。①はプランや使い方で挙動が変わるので、想定タスクの実行時間と無人度を先に決めて評価すると判断を間違えにくい。

 みっつめ。4段階モデルで自分の現在地を確認し、次の一歩を選ぶ。① にいるなら ② へ、② にいるなら ③ へ、③ で運用しつつ自動化要件が出たら ④ を検討する、という段階的な進化が自然です。いきなり ④ に飛ぶ必要はないし、過渡期の混在は妥当な選択です。

 最後に、broker だけで安全は完成しないことも書いておきます。AI ができる操作の範囲は、Claude Code の settings.json の allow / deny、hook、sandbox / container といったパーミッション側で別途設計する必要があります。broker は「クレデンシャルの渡し方」の話、permission は「AI ができる操作の範囲」の話。両方をペアで設計しないと穴が残ります。

 自分の用途(タスクの長さ × 無人度 × 規模)に当てはめて、判断軸を選んでみてください。これは単なるツール選定の話ではなく、どこまでの権限をAIに委譲するのかという設計判断そのものでもあります。最近は、ずっとそのことを考えています。

※2026/05/06追記 やりたい事の全体像をまとめたブログも公開しました。クレデンシャル設計とパーミッション設計を考えたくて、先行してクレデンシャルについて考えたのが本記事になります
blog.takuros.net


booth.pm

booth.pm

技術書典20参加レポート:会場+29%は来場者数の追い風、オンライン+72%は毎日の発信が効いた

 2026年4月11日から26日まで開催された技術書典20が、無事に終了しました。前回エントリでは初動2日分の速報を共有しましたが、オンライン会期も含めた全期間の集計が出揃ったので、改めて振り返りをまとめておきます。基本的には次回出展する自分へのメモですが、これから出展される方や同じく出展されている方にとってのヒントにもなれば幸いです。

 なお、前回(技術書典19)の振り返りはこちらにあります。比較で参照する数字はこの記事から引用しています。

blog.takuros.net

技術書典20 全体結果 / 前回比+54%の803冊

 まずは結論から。

項目 技術書典19 技術書典20 増減
冊数
520冊
803冊
+54.4%
オンライン
308冊
530冊(66%)
+72.1%
会場
212冊
273冊(34%)
+28.8%

 コロナ以降の自己最高記録を更新する結果になりました。事前予測(700冊)も上回っています。新刊2冊体制と最終日プッシュという2つの大きな打ち手が噛み合った結果だと感じています。

書籍別販売実績

書籍 オンライン 会場 合計
⑨エンジニアとお金(新刊)
286冊
100冊
386冊
⑧Organizations本(新刊)
145冊
78冊
223冊
⑩よもやま話
54冊
35冊
89冊
⑦S3本
16冊
18冊
34冊
⑥IAM2025
13冊
20冊
33冊
①IAM初代
5冊
6冊
11冊
③データ分析基盤(設計)
4冊
5冊
9冊
④昔話
2冊
4冊
6冊
②アカウントセキュリティ
1冊
4冊
5冊
⑤データ分析基盤(性能)
1冊
3冊
4冊
合計
530冊
273冊
803冊

※その他若干の販売を含むため、各行の合計と合致しない部分があります

 ポイントは以下です。

  • 新刊2冊で全体の76%(609冊)を占めた。1冊だけなら技術書典19以下に終わっていた可能性が高い
  • 『エンジニアとお金』だけで全体の48%。Organizations本と合わせて76%
  • 『エンジニアとお金』(386冊)はOrganizations本(223冊)の1.7倍。個人のお金というテーマがAWS技術書の購買層を超えて広がった
  • 既刊の会場クロスセル比率が高い。IAM2025=61%・S3本=53%が会場購入で、新刊購入のついで買いがしっかり機能している
  • 一方で既刊のオンライン単品は4〜13冊と低調。ここは次回への課題

日別の販売推移 / オンライン・オフラインの動き

 今回いちばん重要だと感じたのが日別の動きです。会期16日間で何が起きていたかを並べます。

日付 オンライン 会場 合計 メモ
4/11(土)
82冊
0冊
82冊
オンライン開始日
4/12(日)
89冊
273冊
362冊
会場日。全体の45%を1日で達成
4/13(月)
41冊
0冊
41冊
会場後の反響購入
4/14(火)
26冊
0冊
26冊
–
4/15(水)
18冊
0冊
18冊
–
4/16(木)
17冊
0冊
17冊
–
4/17(金)
9冊
0冊
9冊
谷
4/18(土)
20冊
0冊
20冊
週末で一時回復
4/19(日)
15冊
0冊
15冊
–
4/20(月)
5冊
0冊
5冊
谷底
4/21(火)
7冊
0冊
7冊
谷底
4/22(水)
12冊
0冊
12冊
宣伝再開で底打ち
4/23(木)
15冊
0冊
15冊
累計15,000冊投稿が引き金
4/24(金)
8冊
0冊
8冊
–
4/25(土)
47冊
0冊
47冊
最終日プッシュ開始
4/26(日)
119冊
0冊
119冊
真の最終日。ラストスパート
合計
530冊
273冊
803冊
–

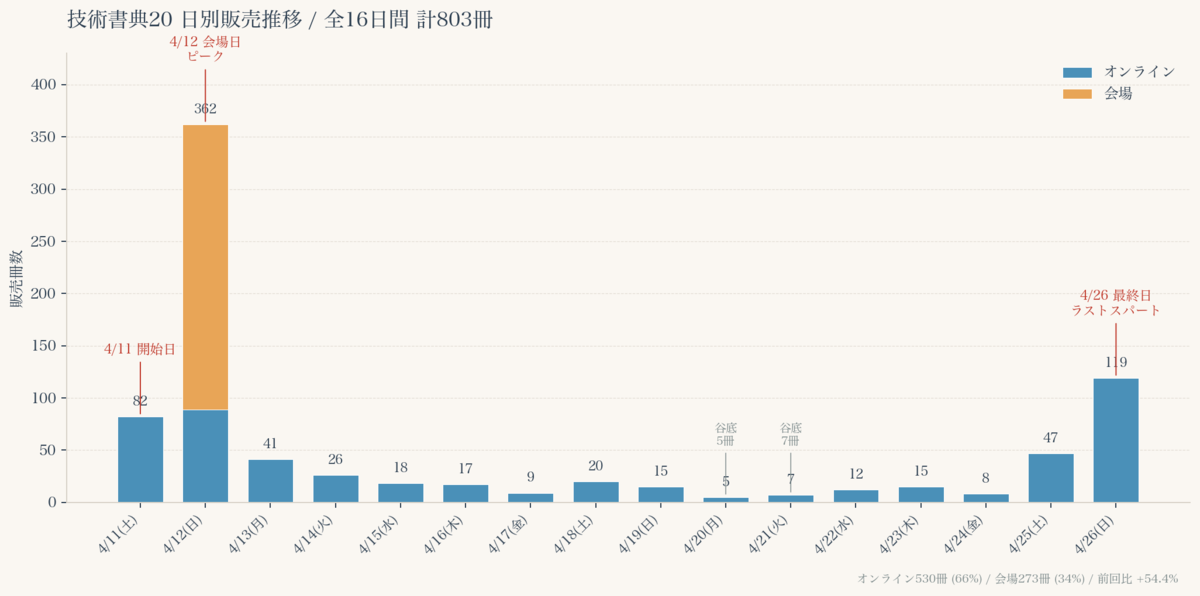
 会期の三大ピークは「4/12 会場日(362冊)」「4/26 最終日(119冊)」「4/11 開始日(82冊)」の3日で、合計で全体の70%を占めます。当初の予測では4/11がもっと大きく、最終日はもっと小さい想定でしたが、最終日のラストスパートが想像以上に効きました。

 また、4/19〜21の3日間は谷底で、合計27冊。Xの投稿数を絞ったタイミングと完全に重なっており、「平日に発信を切らすと売上が即座に落ちる」ことが今回の数字でハッキリ確認できました。

オンライン売上の動き / 今回の伸びの主役は実はオンラインだった

 日別の表を眺めていて気付くのは、会場日(4/12)以外はすべてオンライン分だということです。改めて前回(技術書典19)とチャネル別に比較すると、オンライン側の伸びが際立っています。

項目 技術書典19 技術書典20 増減
全体
520冊
803冊
+54%
会場
212冊
273冊
+29%
オンライン
308冊
530冊
+72%
オンライン比率
59%
66%
+7pt

 会場+29%は来場者数+29%という追い風がそのまま乗った結果でしたが、オンラインは+72%と全体平均(+54%)を大きく超えています。「ブース効率は横ばい・オンラインは劇的に伸びた」というのが今回の本当の構図です。

 オンライン530冊のうち、新刊2冊(『エンジニアとお金』286冊+Organizations本145冊=431冊)で81%を占めます。つまりオンライン+222冊の伸びの大半は新刊2冊化が直接の要因です。そのうえで、純粋にオンライン側の工夫として効いた要素を分解すると以下です。

1. 『エンジニアとお金』がAWS外のテーマとしてオンラインで広く取られた

 『エンジニアとお金』のオンライン286冊は、Organizations本の145冊の約2倍です。会場(100冊 vs 78冊)よりオンラインでの差が顕著で、『エンジニアとお金』のオンライン比率は74%、Organizations本は65%でした。個人のお金というテーマがAWS技術書の購買層を超えて広がり、それがオンライン側に強く出た形です。

 あわせて目立ったのが、『エンジニアとお金』の電子のみ89冊が他書より極端に多かった点です。少し補足が必要なのですが、技術書典では会期中はオンライン購入でも物理本が送料無料、かつ自分は電子版単体と紙+電子セットを同価格に設定しています。つまり電子のみを選ぶ経済的理由はありません。それでも89人が電子のみを選んだのは、紙の本そのものを持たないと割り切る読み方を意識的に選んだ人が、それだけいたということだと見ています。『エンジニアとお金』はAWS本のように机に置いて何度も引くリファレンスとしてではなく、一読して自分のことを考える材料として読まれている、というのがこの数字の解釈として自然です。

2. 最終日に発信を集中させると押し込める

 4/26は会期最終日で、119冊。会場日の362冊に次ぐ会期2位の数字でした。前日4/25=47冊・前々日4/24=8冊と比べると、最終日に発信を集中させた1日で一桁台から3桁に跳ねていることが分かります。会期終了を告知すれば、それで読者の購入の背中を押せる余地がまだ残っていた、ということでした。

3. 開始日(4/11)の集中宣伝

 4/11の82冊もすべてオンライン分です。オンライン会期16日間の入り口でアクセルを踏めるかどうかが、その後の指名買いも含めて全体の動きに影響します。

4. 会期16日間を意識した発信

 累計実績ポスト・サンプル公開・新刊解説など、オンライン期間中の能動的な発信が前回より増えました。逆に中盤4/19〜21の谷も同じメカニズムの裏返しで、発信を絞った3日間で15〜30冊取りこぼしているのも、すべてオンライン側で起きています。

ここから見えること

 会場販売は枠の商売、オンライン販売は働きの商売、と整理すると分かりやすいです。会場の天井は来場者数というハコの大きさで決まり、ブース側の改善がない限りそこで頭打ちになります。一方でオンラインは、会場に足を運ばない読者にも、来られる読者にも届くチャネルです。発信した分だけ反応が返ってくる、いわば積み上げで伸ばしていける世界で、伸びしろの天井が会場より素直に上に伸びます。今回もそこを取りに行けた部分が、結果として伸びを作りました。逆に言うと、来場者数増という追い風が効かないオンライン側こそが次回以降の主戦場で、平日宣伝の空白を潰す・既刊の外部誘導を整える・最終日プッシュを準備するといった改善は、すべてオンラインの伸びしろに直結します。

プラットフォーム側のトレンドも見ておく

 ちなみに技術書典の運営側のデータも、技術季報 Vol.19 / Vol.20 で公開されています。注目したいのは2つです。

  • 技術書典のオンラインアカウント数は技術書典18時点で7万人を超え、Vol.20でも依然「7万人超・10万人も近い将来」と表現されています。会員数自体は18から20まで大きな変動はなさそうです
  • 一方でファン1人あたりの平均購入冊数は、技術書典15→16→17→18で 4.9→4.8→5.2→6.3冊と直近で急増。平均購入金額も¥3,900→¥4,000→¥4,100→¥5,200と+33%伸びています

 つまり、技術書典オンラインは「会員数を増やすフェーズ」というよりも「会員1人あたりの購買意欲が増えているフェーズ」に入っています。当サークルのオンライン+72%のうち、いくらかはこの全体トレンド(1人あたり購買意欲の増加)に乗ったぶんで、純粋に当サークル固有の上積みはそこから差し引いた残り、と読むのが妥当です。「会員数の追い風」ではなく「読者の購買意欲の追い風」、という違いは次回の戦略にも効いてきます。読者の購買意欲が高まっているフェーズだからこそ、新刊2冊体制や既刊の動線整備の効果が乗りやすい、というのが今回の構造でした。

会場(4/12)の時間帯別 / 過去回との比較

 前回エントリにも掲載した、会場販売の時間帯別比較です。今回は技術書典20の列を加えました。

時間 技術書典7 技術書典14 技術書典15 技術書典17 技術書典18 技術書典19 技術書典20
10:00
–
–
–
–
–
–
12冊
11:00
151冊
43冊
24冊
42冊
62冊
42冊
60冊
12:00
94冊
37冊
23冊
43冊
55冊
44冊
56冊
13:00
82冊
48冊
30冊
37冊
48冊
51冊
42冊
14:00
43冊
25冊
49冊
28冊
47冊
40冊
51冊
15:00
45冊
22冊
26冊
28冊
24冊
19冊
36冊
16:00
36冊
11冊
4冊
17冊
19冊
16冊
16冊
合計
451冊
186冊
156冊
195冊
264冊
212冊
273冊
来場者数
9,700人
2,100人
2,200人
2,600人
2,800人
2,400人
3,100人

※集計漏れ等もあり、数字が一致しないところがあります(合計値が正しい)

 会場販売273冊は、コロナ以降の技術書典では過去最高です。特徴的だったのは午後の14時台に51冊と山が立った点で、過去回ではこの時間帯に20〜49冊だったので、今回は午後の動きが大きかったといえます。新刊2冊体制で、お昼の波の後にもう一度ピークが立つ構造になりました。

 来場者数も今回は3,100人で、前回(2,400人)から+29%でした。会場販売も212→273で+29%とほぼ同率で増えており、来場者あたりの販売効率(212/2,400=8.83%、273/3,100=8.81%)はほぼ同じです。今回のオフライン売上の伸びは、ブースの効率改善よりも技術書典自体の盛り返しに相当依存しているということになります。逆に言うと、ブース単体としては来場者数×一定の通過購入率の上限に張り付いている状態で、ここを次に押し上げる打ち手(例: ポスタースタンドでの認知強化、価格表の事前印刷でピーク捌き効率向上)は次回の伸びしろとしてまだ残っています。

X(Twitter)発信と売上の相関

 今回はじめて投稿数と売上を日次で照合してみたところ、かなり強い相関が出ました。

日付 投稿 インプ URLクリック RT 売上(冊)
4/11
40
20,208
173
19
82
4/12
34
18,826
82
14
362
4/13
27
16,227
136
15
41
4/14
15
9,767
103
8
26
4/15
21
13,580
94
12
18
4/16
21
12,510
98
15
17
4/17
20
9,969
32
6
9
4/18
32
15,999
81
7
20
4/19
10
4,027
17
1
15
4/20
11
6,663
42
2
5
4/21
4
3,592
28
1
7
4/22
17
10,616
34
4
12
4/23
19
9,045
102
8
15
4/24
15
6,114
56
9
8
4/25
35
13,893
149
9
47
4/26
62
22,079
168
32
119

 わかりやすかったのは、中盤4/19〜21の「投稿4〜11件しかなく、売上5〜15冊」と、最終日4/26の「62投稿で売上119冊」のコントラストです。「ツイートを切らさない」が売上の前提条件であることを、はっきり数字で確認できました。新刊告知ポストも単発ではインプ約32,800・URLクリック471・RT65と桁違いの数字が出ており、新刊告知が最強の集客装置でもあります。

毎日の運用フローと、生成AIによる省力化

 会期中は、夜にまとめて以下のルーティンを回していました。

  • 前日までの売上データを取得し、書籍別・チャネル別に集計
  • 当日までに発信したポストのインプレッション・URLクリックを確認
  • 翌日のツイート3〜5本を下書き・予約セット

 オンライン会期は16日間あり、これを毎日完全に手動で回すのはしんどい作業です。今回は、これらのかなりの部分を生成AIに任せて省力化しました。具体的には、メールやマイページから取った売上データの整形と集計、過去ポストのパフォーマンス傾向の整理、それらを踏まえた翌日のテーマ提案や下書き生成までを生成AIで整理する、という使い方です。これがあったからこそ、平日も含めて発信を続けられた部分は確かにあります。

 ただし、ツイート本文の最終調整は必ず自分の手で行いました。生成AIが出した下書きの文体や言い回しを自分のものに整え直したうえで投稿する、というラインは引いていました。これは次回も変えないつもりです。

 なお、4/19〜21の谷は、ちょうど集計・下書き生成のフロー自体を自分の手元で一度止めてしまった時期と重なっています。下書きまでは仕組み化、最後の仕上げは手作業というバランスが崩れた瞬間に売上が落ちる、という結果がはっきり出た形でした。

効いた施策 Top 5

1. 新刊2冊体制を続けたこと

 新刊1冊だけだった場合のシミュレーションでは、Organizations本のみなら約280冊(技術書典19以下)、『エンジニアとお金』のみなら約400冊(技術書典19並み)。2冊出したからこそ803冊に到達できたという計算です。コストはかかりますが、これがいちばん再現性のあるレバーです。

2. 最終日プッシュ

 4/26は朝・昼・夕・夜・終了直前と段階的にツイートを投下し、62投稿で119冊。投稿数が直接売上に紐づきました。次回はこの最終日効果を最初から織り込みます。

 ここで補足しておきたいのは、62投稿の中身が必ずしも自分の書籍の紹介一色ではなかった、という点です。実際には今回購入した他サークルの本の感想や紹介、他の出展者のツイートの引用・リポストが半分くらいを占めていました。最終日のタイムラインは「終わりが近い」という空気で同人誌コミュニティ全体が盛り上がる時間帯で、そこにコミュニティ参加者として自然に乗ったのが結果として効いた印象です。出展者同士の相互送客も生まれますし、自分の宣伝ばかり連投するアカウントよりも届く範囲が広がります。「最終日は自分の宣伝で押す」と考えると逆に届かない可能性があり、他出展者・購入本の紹介を厚く混ぜるほうが結果的に自分にも返ってくる、というのが今回の感触でした。

3. 会場でのクロスセル

 会場273冊のうち、新刊+既刊の組み合わせ買いがかなり多かった印象です。ポップでシリーズ全体を見せ、既刊それぞれの役割の違いを口頭で説明したのが効きました。ただし後述するように、会場販売の伸び(+29%)は来場者数の伸び(+29%)と完全に同率で、来場者あたりの購入率は技術書典19から横ばい(約8.8%)。クロスセルが効いているのは事実ですが、技術書典19から20でブース効率が上がったわけではない、という冷静な認識も必要です。

4. 開始日の集中宣伝

 4/11はオンライン開始のタイミング。40投稿でインプ約20,000、初日82冊。先頭でアクセルを踏むことで、その後の指名買いに繋がりました。

5. 『エンジニアとお金』というテーマの裾野

 『エンジニアとお金』386冊は全体の48%、Organizations本(223冊)の1.7倍。AWS技術書の購買層を超えて広く取られたのが今回いちばんの新発見です。電子のみ89冊が他書より極端に多かった点も特徴的で、送料無料・同価格でも紙+電子セットを選ばなかった層が一定数いたことを意味します。AWS本のように机に置いて何度も引くリファレンスとは違う読まれ方をしている、と解釈しています。AWS本では届かない層と読まれ方に届くテーマを1冊持っておく意義は大きい、と確認できました。

反省と次回(技術書典21)への持ち越し課題

中盤の宣伝空白(4/19〜21)

 投稿を絞った3日間で、明確に売上が落ちました。推定で10〜15冊の機会損失です。次回は平日も最低3投稿/日を機械的に維持します。具体的には前週末にまとめて予約投稿を仕込み、忙しい日でも空白が出ないようにします。

既刊オンライン販売の弱さ

 会場では既刊もしっかり動きますが、オンラインでは既刊単品が4〜13冊と低調でした。技術書典オンラインのプラットフォーム制約(バンドル不可・お勧め3枠のみ・商品間リンク弱め)に依存せず、外部から各既刊ページに直接送客する設計に切り替える必要があります。具体的な対策として:

  • 各商品の説明欄を「誰のための本か」「シリーズマップ」「あわせて読みたい関連既刊」のランディングページ化
  • お勧め3枠を「既刊→既刊」連鎖型に再設計(新刊同士で互いを推す必要は薄いと判明)
  • 新刊の巻末に既刊一覧ページ(QRコード+1行紹介)を追加
  • サークル案内ハブページを1枚作って、ピン留め・プロフィール・ブログ末尾・新刊中の全導線をそこに集約

最終日プッシュの予習不足

 4/26は119冊でしたが、もっと早く全力モードに入っていたら150冊いけた可能性があります。次回は最終日プッシュ用のストック投稿を10本準備しておきます。当日その場で書こうとすると質が落ちるので、各書の見どころ・感想ピックアップ・残り時間カウントダウンを事前にテンプレ化しておきます。

データ取得タイミング

 最終日(4/26)当日朝にデータを取ると、最終日の販売分(119冊)を取り逃がします。集計は終了翌々日(月曜)以降に取得するのを徹底します。マイページのCSVエクスポートを正、メールmboxはバックアップという位置付けに。

会場の通過購入率の頭打ち

 今回新しく見えた課題が、会場ブースの通過購入率です。冒頭の比較表で見た通り、来場者数 +29%・会場販売 +29% で、来場者あたり購入率は約8.8%で技術書典19から横ばい。会場販売の伸びはブース改善ではなく技術書典の盛り返し由来でした。来場者数が頭打ちになった瞬間に会場売上も頭打ちになる構造なので、ここを次の伸びしろとして攻める必要があります。具体策:

  • ポスタースタンドで縦の空間活用。離れた通路からも認知される導線を作る
  • 価格表・組合せ案内を事前印刷して机上に置く。即決を促す補助物
  • ピーク時間帯(11時の60冊)のバックアップ要員確保。会計の詰まりが機会損失に直結する
  • 新刊以外の書籍にも個別ポップ(誰のため・3行サマリ)を用意し、視線が新刊だけに集中するのを防ぐ

数値目標

 次回(技術書典21)の数値目標は以下です。来場者数の追い風が無い前提(3,100人で横ばい想定)で組んでいます。

指標 技術書典19実績 技術書典20実績 技術書典21目標 前提・根拠
冊数
520
803
900〜1,000
平日宣伝強化+既刊外部誘導+新刊2冊継続
新刊比率
–
76%
70%超を維持
新刊2冊体制を続ける
既刊オンライン
–
14冊
40〜70冊
外部ハブ+商品説明欄改善
会場通過購入率
8.83%
8.81%
10%〜
ポスタースタンド・価格表・要員配置
会場販売(来場3,100人想定)
212
273
310〜340
通過購入率の改善ぶん

他の出展者の方へのヒント

 ここまでは自分向けの記録ですが、これから技術書典に出展される方や、同じく試行錯誤されている方に向けて、自分の経験から拾えるところを書いておきます。

新刊は出せるなら絶対に出す

 新刊がない回(自分の場合:技術書典15・17)は合計が半減します。新刊はそれ自体が売れるだけでなく、ブースに人を呼ぶ集客装置としても機能します。半年に1冊ペースが回せれば、既刊の売上も維持されます。

平日も切らさない

 土日に投稿が多いのは自然ですが、平日に空白を作ると翌日以降の売上に直接効いてきます。最低でも1日3投稿、内容は「感想紹介」「書籍ピック」「雑談」くらいに分散させると詰まらないです。今回の自分の数字(4/19〜21の谷)で因果がはっきり見えました。

最終日は本気で

 最終日は思っているより売れます。当日その場でツイートを書こうとすると質が落ちるので、ストック投稿を事前に用意しておくのがおすすめです。朝・昼・夕・夜・終了直前の5回が最低ライン。今回の119冊はその気付きで言えば「もっと早く本気を出せていたら」案件です。

既刊の動線を別途作る

 技術書典オンラインの商品間リンクは弱いので、サイト・ブログ・ピン留めツイート・新刊巻末などにシリーズ全体のハブを置くのが効きます。新刊を入口に既刊まで連れていく動線を、技術書典の機能に頼らず自前で作るイメージです。

数字を残す

 ツイート数、インプレッション、売上を日別に並べて見ると、施策の効果が客観的に見えます。気合で頑張るより、数字で振り返るほうが次に繋がります。今回の自分の振り返りも、すべてここから始まりました。受信メールやマイページのエクスポートをスクリプトで集計するだけでも、見える景色が変わります。

来場者数も合わせて記録する

 今回もう一つ大きな気付きがあって、自分の販売数だけでなく技術書典の公式来場者数も毎回記録しておくと、自分の伸びがブース改善によるものか、イベント自体の伸びによるものかが切り分けられます。今回の自分のケースで言えば、会場販売+29%の中身は実のところ来場者+29%×ほぼ同じ通過購入率で、ブース改善はほとんど寄与していなかった、ということが見えました。来場者あたりの購入率(自分の場合は約8.8%)を毎回追うと、ブース運営の改善が効いているのか錯覚なのかが分かるのでオススメです。

生成AIで省力化しつつ、最後の一文は自分で書く

 毎日の集計やツイート下書きは生成AIにかなり任せられる時代になりました。会期中の運用負荷は確実に下がるので使わない手はないのですが、出てきた下書きをそのまま投稿するのはおすすめしません。データ整理・パフォーマンス分析・下書き生成・テーマ提案までは仕組み化し、読者の目に触れる本文の最終調整は人間が手で整える、というラインを引いておくのが現実的だと考えます。

まとめ / 次回(技術書典21)に向けて

 技術書典20は、新刊2冊・『エンジニアとお金』という新テーマ・最終日プッシュの3つの打ち手が噛み合って、前回比+54%の803冊という結果になりました。チャネル別に見ると、会場+29%は来場者数+29%の追い風がそのまま乗った結果で、ブース効率自体は横ばい。一方でオンラインは+72%と全体平均を大きく超えており、今回の伸びの主役はむしろオンラインでした。会場は枠の商売、オンラインは働きの商売、という構図が今回はっきり見えた回でもあります。一方で、中盤の宣伝空白・既刊オンライン販売の弱さ・会場ブースの通過購入率の頭打ち、という3つの改善余地も同時に浮かびました。来場者数の伸びに依存しないブース設計と、発信の密度に応答するオンライン側の打ち手の作り込みが、次の伸びしろです。

 次回は900〜1,000冊を目標に、『エンジニアとお金』に続く2冊目の検討、既刊用の外部ハブ整備、ブース回りの認知強化(ポスタースタンド・価格表・要員配置)を中心に動こうと思っています。「3日に1度しか発信しない」「既刊はオンラインの機能任せ」「会場は来場者数任せ」という、今回ボトルネックになった3点を構造から潰すのが次の宿題です。

技術書典が終わったあとの買い方について

 最後に、今回の本を「あとから読みたい」と思ってくださった方に向けて、販売チャネルの整理だけ書いておきます。会期が終わったあとは、BOOTHとKindleの2つで継続販売しています。この2つは、売っている本ではなく売っている相手が違うチャネルだと思っています。

BOOTH(紙+PDFセット/PDF単体)

 BOOTHは、技術書典の延長で自分が在庫と価格をそのまま持ち続けている場所です。技術書典で買えた紙+PDFセットや、PDF単体版がそのまま並んでいて、シリーズ買いや全巻セットもこちらに置いています。今回の記事で何度か触れた「IAM初代+IAM2025の2冊セット」「データ分析基盤の設計+性能の2冊セット」のような読み方をしたい方には、BOOTHの方が動線として素直です。手数料が低いぶん、こちらで買っていただけると著者側にもしっかり届きます。

佐々木拓郎のオンライン本屋

Kindle(電子のみ)

 Kindleは、技術書典やBOOTHを普段使わない読者に届けるための場所です。AWSコミュニティの外、たとえば業務でAWSを触り始めた方や、書店アプリ経由で技術書を探している方の手に渡るのは、ほぼKindle経由です。今回の『エンジニアとお金』のような、AWSの外側の読者層にも関わるテーマは特に、Kindle化を進めていく予定です。手元で検索しながら読みたい方や、Kindle Unlimitedを使っている方にはこちらをおすすめします。

AWSの薄い本

まとめ — 次回もよろしくお願いします

 今回手にとっていただいた皆さま、本当にありがとうございました。会期が終わったあとも、BOOTHとKindleで本は残り続けます。気になっていた巻があれば、ぜひそちらからお迎えください。
 次回の技術書典21でもまたお会いできるよう、引き続き書いていきます。